跳转至

二维Gaussian分布Wasserstein 距离的推导以及其在目标检测中的应用

⏱ 约 80 分钟

本文写于2026年07月27日晚上九点

前言

Wasserstein 距离无论是在GAN网络还是在目标检测中都会经常碰到,结合最近读的三篇文章想梳理一下系统这方面内容,从零到一的完成针对二维高斯分布的Wasserstein距离推导。

目标检测器通常同时学习两类任务:分类回答“这是什么”,定位回归回答“它在哪里”。本文只聚焦定位部分。一个预测框和真值框越接近,回归 loss 应越小;问题是“接近”究竟怎样定义。

常规水平框常写成

\[ B=(c_x,c_y,w,h), \]

旋转框再增加角度:

\[ B=(c_x,c_y,w,h,\theta). \]

直接对这些参数做 Smooth L1/L2 有两个明显缺点:

  1. 参数误差和最终 IoU 不完全一致。例如同样的角度误差,对细长目标的 IoU 破坏远大于近方形目标。
  2. 旋转框有多套等价参数。交换 \(w,h\) 并把角度加减 \(\pi/2\),可能仍表示同一个几何矩形;角度加\(\pi\) 也不改变矩形。参数 loss 却可能在这些边界突然跳变。

本文作为主线详细解读的三篇论文,其完整英文题名是:

  1. GWD:Rethinking Rotated Object Detection with Gaussian Wasserstein Distance Loss1;
  2. NWD:A Normalized Gaussian Wasserstein Distance for Tiny Object Detection2;
  3. EWD:Edge Wasserstein Distance Loss for Oriented Object Detection3。

三篇论文的共同想法是:先把框变成概率分布,再比较分布123。

论文 检测对象 分布表示 距离怎样进入系统
GWD1 旋转矩形 整个框映射成二维 Gaussian \(W_2^2\) 经非线性函数变成回归 loss
NWD2 微小水平矩形 轴对齐二维 Gaussian \(W_2\) 经指数变成 \([0,1]\) 相似度,用于分配、NMS、loss
EWD3 旋转矩形/多边形 概率质量只放在边缘;EGWD 对每条边使用退化 Gaussian 匹配对应边后求近似 Wasserstein 代价,再做尺度和非线性变换

需要注意的是:

  1. 三篇论文并没有都把最终 loss 直接设成 Wasserstein 距离。

    • NWD 先算 \(W_2\),再算 \(\exp(-W_2/C)\),最终 loss 是 \(1-\exp(-W_2/C)\)。
    • GWD 先算 \(d^2=W_2^2\),再用 \(1-1/(\tau+f(d^2))\)。
    • EWD 计算的是加了边对应约束的近似平方运输代价,实验中通常再用 \(\log(1+x)\)。
  2. 二维 Gaussian 不是网络预测的不确定性。 在这三篇工作的主线里,Gaussian 分布参数是由框参数唯一算出的几何编码;它没有表达“模型有多确信”。

一、概率与线性代数预备

全文固定使用同一套记号:随机向量用大写 \(X,Y\);确定性向量用小写 \(x,y\);均值统一用 \(\mu\); 协方差统一用 \(\Sigma\);一般比较对象用下标 \(1,2\),进入检测训练后预测框和真值框分别用下标 \(p,g\)。论文原文若使用 \(m\)、\(t\) 或把距离平方简写成 \(W\),只在对照说明中保留,正文公式不随之切换。

1.1 向量、矩阵和欧氏范数

本文把向量写成列向量。例如

\[ x= \begin{bmatrix}x_1\\ \vdots\\ x_d\end{bmatrix} \in\mathbb R^d, \]

\(x^\top\) 表示转置后的行向量。两个向量的内积和欧氏范数分别为

\[ x^\top y=\sum_{i=1}^d x_i y_i, \qquad \|x\|_2=\sqrt{x^\top x} =\sqrt{x_1^2+\cdots+x_d^2}. \]

\(\|x-y\|_2\) 是两点的直线距离,\(\|x-y\|_2^2\) 是距离平方。后文的 \(W_2\) 和 \(W_2^2\) 也必须 这样区分。

矩阵 \(A\in\mathbb R^{m\times n}\) 把 \(n\) 维向量映射成 \(m\) 维向量。\(I_d\) 是 \(d\) 阶单位矩阵, \(I_dx=x\) 。若方阵 \(A\) 存在矩阵 \(A^{-1}\) 使

\[ A^{-1}A=AA^{-1}=I_d, \]

就称 \(A\) 可逆。二维矩阵的行列式和逆矩阵为

\[ A= \begin{bmatrix}a&b\\c&d\end{bmatrix}, \qquad \det A=ad-bc, \]
\[ A^{-1} =\frac1{ad-bc} \begin{bmatrix}d&-b\\-c&a\end{bmatrix}, \qquad \det A\ne0. \]

行列式描述线性变换对有向体积的缩放;后面变量替换中的面积缩放因子正是 \(|\det A|\)。

1.2 概率分布、密度和期望

随机向量 \(X\) 的分布 \(P\) 规定它落入每个集合的概率。若 \(P\) 对通常的体积测度存在密度 \(p_X(x)\),则

\[ p_X(x)\ge0, \qquad \int_{\mathbb R^d}p_X(x)\,\mathrm dx=1, \]

且对区域 \(A\subseteq\mathbb R^d\),

\[ \Pr(X\in A)=\int_Ap_X(x)\,\mathrm dx. \]

“分布”和“密度”不能无条件互换。例如单点质量 \(\delta_a\) 是合法概率分布,却没有普通函数形式的密度。若 \(g(X)\) 可积,其期望定义为

\[ \mathbb E[g(X)] =\int_{\mathbb R^d}g(x)p_X(x)\,\mathrm dx. \]

离散变量只需把积分换成求和。期望的线性性质是

\[ \mathbb E[aU+bV]=a\mathbb E[U]+b\mathbb E[V]. \]

1.3 均值、方差和协方差

随机向量 \(X\in\mathbb R^d\) 的均值向量统一记为

\[ \mu=\mathbb E[X] =\int_{\mathbb R^d}x p_X(x)\,\mathrm dx. \]

一维随机变量的方差是平均平方偏差:

\[ \operatorname{Var}(X)=\mathbb E[(X-\mu)^2]. \]

多维情形把各分量的方差和两两协方差放入矩阵:

\[ \Sigma=\mathbb E[(X-\mu)(X-\mu)^\top]. \]

其第 \((i,j)\) 个元素为

\[ \Sigma_{ij} =\mathbb E[(X_i-\mu_i)(X_j-\mu_j)]. \]

对任意向量 \(v\),

\[ v^\top\Sigma v =\mathbb E\!\left[(v^\top(X-\mu))^2\right]\ge0. \]

所以协方差矩阵对称且半正定,记作 \(\Sigma\succeq0\)。若对每个非零 \(v\) 都\(v^\top\Sigma v>0\),则称其正定,记作 \(\Sigma\succ0\)。半正定允许某个方向的方差为 0;

1.4 特征值、正交矩阵和矩阵平方根

若非零向量 \(q\) 满足

\[ Aq=\lambda q, \]

则 \(q\) 是 \(A\) 的特征向量,\(\lambda\) 是相应特征值。矩阵 \(Q\) 若满足 \(Q^\top Q=I\),称为正交矩阵;它的列向量两两正交且长度为 1,并且 \(Q^{-1}=Q^\top\)。实对称矩阵都可正交对角化。特别地,

\[ \Sigma =Q\operatorname{diag}(\lambda_1,\ldots,\lambda_d)Q^\top, \qquad \lambda_i\ge0. \]

半正定矩阵的主平方根定义为

\[ \Sigma^{1/2} =Q\operatorname{diag}(\sqrt{\lambda_1},\ldots,\sqrt{\lambda_d})Q^\top. \]

直接相乘得到 \(\Sigma^{1/2}\Sigma^{1/2}=\Sigma\)。它仍对称半正定,而且是满足这些条件的唯一平方根。注意一般不能把 \((AB)^{1/2}\) 拆成 \(A^{1/2}B^{1/2}\);只有在 \(A,B\) 可交换等额外条件下才能这样做。

1.5 迹、Frobenius 范数与 SVD

方阵 \(A\) 的迹是对角线元素之和:

\[ \operatorname{Tr}(A)=\sum_i A_{ii}. \]

只要乘积尺寸允许,迹具有循环性质:

\[ \operatorname{Tr}(ABC)=\operatorname{Tr}(BCA)=\operatorname{Tr}(CAB). \]

矩阵的 Frobenius 范数是所有元素平方和的平方根:

\[ \|A\|_F^2=\sum_{i,j}A_{ij}^2=\operatorname{Tr}(A^\top A). \]

任意实矩阵 \(M\in\mathbb R^{m\times n}\) 都有奇异值分解

\[ M=U\operatorname{diag}(s_1,\ldots,s_r)V^\top, \qquad s_i\ge0, \]

其中 \(U,V\) 为正交矩阵,\(r=\min(m,n)\)。\(s_i\) 称为奇异值;它们的平方是 \(M^\top M\) 的 特征值。第 4 节会用 SVD 把“在所有耦合中寻找最大交叉协方差”化成逐个奇异值的标量问题。

二、Wasserstein 距离的定义

2.1 为什么需要“耦合”

先看有限个位置的情形。设源端有位置 \(x_1,\ldots,x_m\),第 \(i\) 个位置存有质量 \(p_i\);目标端有 位置 \(y_1,\ldots,y_n\),第 \(j\) 个位置需要质量 \(q_j\)。把总质量归一化为 1:

\[ p_i\ge0,\qquad q_j\ge0,\qquad \sum_{i=1}^m p_i=\sum_{j=1}^n q_j=1. \]

这两组带权位置就是两个离散概率分布

\[ P=\sum_{i=1}^m p_i\delta_{x_i}, \qquad Q=\sum_{j=1}^n q_j\delta_{y_j}, \]

其中 \(\delta_x\) 表示全部质量集中在位置 \(x\) 的单点分布。仅知道 \(P,Q\),只知道“质量原来在哪里”与“最终要到哪里”,还没有说明源端的每一份质量具体送往哪个目标。

用 \(\gamma_{ij}\ge0\) 表示从 \(x_i\) 运往 \(y_j\) 的质量,所有 \(\gamma_{ij}\) 排成运输矩阵

\[ \Gamma= \begin{bmatrix} \gamma_{11}&\cdots&\gamma_{1n}\\ \vdots&\ddots&\vdots\\ \gamma_{m1}&\cdots&\gamma_{mn} \end{bmatrix}. \]

它必须同时满足两组守恒条件:

\[ \underbrace{\sum_{j=1}^n\gamma_{ij}=p_i}_{\text{源位置 }x_i\text{ 的质量全部运出}}, \qquad \underbrace{\sum_{i=1}^m\gamma_{ij}=q_j}_{\text{目标位置 }y_j\text{ 的需求恰好满足}}. \]

所以矩阵的第 \(i\) 行之和固定为 \(p_i\),第 \(j\) 列之和固定为 \(q_j\)。满足这些约束的每一个\(\Gamma\) 都是一个合法运输方案,但运输方式并不唯一。若每单位质量从 \(x_i\) 到 \(y_j\) 的代价是\(c_{ij}\),则该方案的总代价是

\[ \operatorname{Cost}(\Gamma) =\sum_{i=1}^m\sum_{j=1}^n c_{ij}\gamma_{ij}. \]

这里 \(\gamma_{ij}\) 是运多少质量,\(c_{ij}\) 是每单位质量有多贵,二者不能混为一个量。

下面用一个“在数轴上搬运质量”的具体例子说明。把总质量规定为 1;可以把它想成 1 千克沙子,也 可以把它理解成总和为 1 的概率。开始时,质量分布 \(P\) 有两堆:

源位置 该处原有的质量
\(x_1=0\) \(1/2\)
\(x_2=4\) \(1/2\)

搬运结束后,要得到目标分布 \(Q\):

目标位置 该处需要的质量
\(y_1=1\) \(1/2\)
\(y_2=3\) \(1/2\)

也就是说,源端在位置 0 和 4 各有半份质量,目标端在位置 1 和 3 各要收到半份质量。前面定义过的\(\delta_a\) 表示“全部质量集中在位置 \(a\)”,因此上面两张表可以压缩写成

\[ \underbrace{P=\frac12\delta_0+\frac12\delta_4}_{ \text{位置 0、4 各有 }1/2}, \qquad \underbrace{Q=\frac12\delta_1+\frac12\delta_3}_{ \text{位置 1、3 各需要 }1/2}. \]

注意,\(\delta_0\) 不是数值 0,\(\delta_4\) 也不是数值 4;它们都是概率分布。下标 0 和 4 只说明质量集中在哪个位置,前面的系数 \(1/2\) 才说明该位置有多少质量。

规定“移动距离的平方”为每单位质量的运输成本:

\[ c_{ij}=|x_i-y_j|^2. \]

四条可能路线的单位成本为

\[ C= \begin{array}{c|cc} & y_1=1 & y_2=3\\ \hline x_1=0 & |0-1|^2=1 & |0-3|^2=9\\ x_2=4 & |4-1|^2=9 & |4-3|^2=1 \end{array}. \]

因此,把质量从 0 运到 1 或从 4 运到 3 都比较便宜;交叉地从 0 运到 3 或从 4 运到 1 则比较贵。 但 \(P,Q\) 只规定了起点和终点各有多少质量,没有规定具体走哪条路线。下面给出三种不同的合法方案。运输矩阵的行表示从哪里运出,列表示运到哪里:

\[ \Gamma_{\mathrm{near}} =\begin{array}{c|cc} & y=1 & y=3\\ \hline x=0 & 1/2 & 0\\ x=4 & 0 & 1/2 \end{array}, \qquad \Gamma_{\mathrm{ind}} =\begin{array}{c|cc} & y=1 & y=3\\ \hline x=0 & 1/4 & 1/4\\ x=4 & 1/4 & 1/4 \end{array}, \]
\[ \Gamma_{\mathrm{cross}} =\begin{array}{c|cc} & y=1 & y=3\\ \hline x=0 & 0 & 1/2\\ x=4 & 1/2 & 0 \end{array}. \]

以 \(\Gamma_{\mathrm{near}}\) 左上角的 \(1/2\) 为例,它表示“从位置 0 向位置 1 运送 \(1/2\) 份质量”; 右上角的 0 表示“从位置 0 向位置 3 什么也不运”。\(\Gamma_{\mathrm{near}}\) 把 0 配给 1、把 4 配给3;\(\Gamma_{\mathrm{cross}}\) 正好反过来,走两条较远的交叉路线;\(\Gamma_{\mathrm{ind}}\) 则把源端 每一堆 \(1/2\) 再分成两个 \(1/4\),分别送往两个目标。

三个矩阵的每一行之和都是 \(1/2\),说明两个源点原有的质量都被完整运出;每一列之和也都是 \(1/2\), 说明两个目标点都恰好收到了所需质量。因此三者虽然走法不同,却都是合法耦合。三者的总代价依次为

\[ \begin{aligned} \operatorname{Cost}(\Gamma_{\mathrm{near}}) &=\frac12|0-1|^2+\frac12|4-3|^2=1,\\ \operatorname{Cost}(\Gamma_{\mathrm{ind}}) &=\frac14(1+9+9+1)=5,\\ \operatorname{Cost}(\Gamma_{\mathrm{cross}}) &=\frac12|0-3|^2+\frac12|4-1|^2=9. \end{aligned} \]

这个例子说明:即使三种方案共享同一个起点分布 \(P\) 和同一个终点分布 \(Q\),质量的具体走法仍然可以完全不同,总代价也会随之改变。Wasserstein 距离要寻找的,正是其中代价最低的走法。

现在换一种更容易推广的说法。假设从全部质量中随机挑出一小份,并记录两件事:

  • 用 \(X\) 记录它从哪里出发;
  • 用 \(Y\) 记录它被运到哪里。

例如,在近邻运输方案中,挑中的质量有一半可能走“\(0\to1\)”,另一半可能走“\(4\to3\)”。因此,只看出发位置 \(X\),会看到位置 0 和 4 各占一半,这正是 \(P\);只看终点 \(Y\),会看到位置 1 和 3 各占一半,这正是 \(Q\)。

这里的“只看 \(X\),不管 \(Y\)”叫取第一个边缘分布;“只看 \(Y\),不管 \(X\)”叫取第二个边缘分布。 “边缘”只是一个名称,意思就是忽略运输记录中的另一列。运输矩阵的行和给出 \(X\) 的分布,列和给出\(Y\) 的分布,所以前面检查行和、列和,其实就是在检查两个边缘分布是否正确。

只要一种搭配方式满足下面两项要求,它就是 \(P\) 和 \(Q\) 的一个耦合(coupling)4:

\[ X\text{ 的分布是 }P, \qquad Y\text{ 的分布是 }Q. \]

通常把“\(X\) 的分布是 \(P\)”简写成 \(X\sim P\)。于是,上面的条件也可以简写为

\[ X\sim P, \qquad Y\sim Q. \]

把所有满足这两个条件的搭配方式放在一起,记作 \(\Pi(P,Q)\)。这里的 \(\Pi\) 只是这个集合的名字,可以直接读成“\(P\) 和 \(Q\) 的所有合法耦合的集合”。前面的三个运输矩阵都属于 \(\Pi(P,Q)\)。

连续分布也是同一个意思,只是不再能把所有走法列成有限矩阵。此时用 \(\gamma\) 表示一套完整的搭配规则:它说明一小份质量从每个可能的 \(X\) 运到每个可能的 \(Y\) 的概率。只要单独观察 \(X\) 时得到 \(P\),单独观察 \(Y\) 时得到 \(Q\),就有 \(\gamma\in\Pi(P,Q)\),也就是“\(\gamma\) 是一个合法耦合”。

2.2 \(\inf\) 与 \(\min\)

给定一组实数 \(S\),若 \(a\) 满足两点:

  1. 对所有 \(s\in S\) 都有 \(a\le s\),即 \(a\) 是下界;
  2. 任何比 \(a\) 更大的数都不再是下界;

则 \(a\) 是 \(S\) 的下确界,记作 \(\inf S\)。最小值 \(\min S\) 必须属于 \(S\),下确界却不一定被 取到。例如开区间 \(S=(0,1)\) 没有最小值,但 \(\inf S=0\)。

最优传输先对所有合法耦合的代价取下确界。这样即使尚未证明存在最优耦合,距离定义也有意义。在本文的 Gaussian 二次代价情形,第 4 节还会显式构造达到下确界的联合 Gaussian;那时 \(\inf\) 确实也是一个 \(\min\)。

2.3 \(p\) 阶 Wasserstein 距离

先选择一个数 \(p\ge1\)。它决定远距离运输会受到多强的惩罚。还要求 \(P,Q\) 的“距离原点的 \(p\) 次方”具有有限平均值;这个技术条件称为具有有限的 \(p\) 阶矩,作用是保证下面的距离不会变成无穷大。 本文使用的 Gaussian 分布都自动满足这个条件。

先不要看完整定义,只看一对起点和终点。设

\[ x=(x_1,\ldots,x_d), \qquad y=(y_1,\ldots,y_d). \]

这里 \(d\) 是点的坐标个数:平面中的点有两个坐标,所以目标检测中通常有 \(d=2\)。从 \(x\) 到 \(y\) 的直线距离是

\[ \|x-y\|_2 =\sqrt{(x_1-y_1)^2+\cdots+(x_d-y_d)^2}. \]

现在可以逐个读懂 \(\|x-y\|_2^p\):

部分 含义
\(x-y\) 从起点 \(x\) 指向终点 \(y\) 的位移;正负号不影响最终距离
\(\|\;\|\) 把位移变成一个非负的长度
右下角的 \(2\) 指定长度使用欧氏距离,即“各坐标差的平方和再开平方”;这个 2 不是平方运算
右上角的 \(p\) 把已经算出的欧氏距离再取 \(p\) 次方;这是运输一单位质量的成本

因此

\[ \boxed{ \|x-y\|_2^p =\left[(x_1-y_1)^2+\cdots+(x_d-y_d)^2\right]^{p/2} }. \]

例如在二维平面中,若 \(x=(1,2)\)、\(y=(4,6)\),则

\[ \|x-y\|_2=\sqrt{(1-4)^2+(2-6)^2}=5. \]

当 \(p=1\) 时,运输成本是 \(5^1=5\);当 \(p=2\) 时,运输成本是 \(5^2=25\)。注意即使 \(p=1\),范数右下角仍然是 2,因为这里始终使用直线距离,而不是更换距离的种类。

把一对点的成本推广到两个分布,得到 \(p\) 阶 Wasserstein 距离的正式定义:

\[ W_p(P,Q) =\left( \inf_{\gamma\in\Pi(P,Q)} \int_{\mathbb R^d\times\mathbb R^d} \|x-y\|_2^p\,\mathrm d\gamma(x,y) \right)^{1/p}. \tag{2.1} \]

式 (2.1) 应当按照从内到外的顺序阅读:

  1. \(\|x-y\|_2^p\):计算一份质量从 \(x\) 运到 \(y\) 的成本。
  2. \(\int\cdots\mathrm d\gamma(x,y)\):按照耦合 \(\gamma\) 规定的运输比例,把所有路线的成本加权平均。 \(\mathrm d\gamma(x,y)\) 表示“权重由 \(\gamma\) 决定”,不是把公式乘以一个叫作 \(\mathrm d\gamma\) 的数。
  3. \(\inf_{\gamma\in\Pi(P,Q)}\):让 \(\gamma\) 遍历 \(P,Q\) 的所有合法耦合,选出最小的平均成本。
  4. 外层上标 \(1/p\):对最小平均成本取 \(p\) 次方根。例如 \(p=2\) 时,上标 \(1/2\) 就是开平方。
  5. \(W_p\) 右下角的 \(p\):标记这是第几阶 Wasserstein 距离。它与成本中的上标 \(p\)、外层的 \(1/p\) 使用同一个数。

外层为什么要取 \(p\) 次方根?因为 \(\|x-y\|_2^p\) 的单位是“长度的 \(p\) 次方”;开 \(p\) 次方根后, \(W_p\) 重新具有长度单位,才能称为距离。例如像素距离平方的单位是像素平方,最后开平方又回到像素。

等价地,若 \((X,Y)\) 的联合分布取遍所有满足 \(X\sim P,Y\sim Q\) 的耦合,

\[ W_p(P,Q) =\inf_{X\sim P,\,Y\sim Q} \left(\mathbb E\|X-Y\|_2^p\right)^{1/p}. \tag{2.2} \]

本文三篇论文关心的是 \(p=2\):

\[ W_2^2(P,Q) =\inf_{\gamma\in\Pi(P,Q)} \mathbb E_\gamma\|X-Y\|_2^2. \tag{2.3} \]

式 (2.3) 是距离的平方。有些目标检测论文为了简写把右边直接记成 \(W\),这会导致后续的平方根位置难以判断。本文始终使用 \(W_2\) 和 \(W_2^2\) 两个不同符号。

2.4 两个最小例子

第一个,若 \(P=\delta_a,Q=\delta_b\) 都是单点质量,唯一耦合只能把 \(a\) 运到 \(b\),所以

\[ W_p(\delta_a,\delta_b)=\|a-b\|_2. \]

第二个,若两个分布的支撑完全不重叠,Wasserstein 距离仍然有定义:它计算把一边质量移到另一边需要多大位移。相比之下,两个不相交框的 IoU 直接等于 0,无法再区分“差 1 像素”和“差 100 像素”。这正是WD 被引入框回归的直觉来源。

2.5 Wasserstein、Earth Mover's Distance 和最优传输不是同一个具体公式

“最优传输”是整个优化问题族;\(W_p\) 是在欧氏地面代价 \(\|x-y\|^p\) 下得到的一类距离; Earth Mover's Distance 常用来指离散情形的 \(W_1\)。GWD/NWD 使用的是 \(W_2\),而 OTA 把目标检测的标签匹配写成运输计划5。它们有共同数学祖先,但运输对象和代价函数不同。

三、二维 Gaussian 分布

3.1 一般定义

二维随机向量 \(X=(X_1,X_2)^\top\) 服从 Gaussian 分布

\[ X\sim\mathcal N(\mu,\Sigma), \]

其中

\[ \mu= \begin{bmatrix}\mu_x\\\mu_y\end{bmatrix}, \qquad \Sigma= \begin{bmatrix} \sigma_x^2 & \rho\sigma_x\sigma_y\\ \rho\sigma_x\sigma_y & \sigma_y^2 \end{bmatrix}, \]

\(\sigma_x,\sigma_y>0\),\(|\rho|<1\)。

概率密度需要回答“平面上某个具体位置附近的密度是多少”。任取一个坐标为 \((x,y)\) 的平面点,并把它的两个坐标排成列向量:

\[ z= \begin{bmatrix}x\\y\end{bmatrix}. \]

这里的三个记号分工如下:

  • 大写 \(X\) 是尚未确定取值的随机向量;
  • 小写 \(z\) 是拿来代入密度公式的一个具体平面点;
  • 小写 \(x,y\) 是点 \(z\) 的横坐标和纵坐标。

\(z\) 不是 Gaussian 的新参数,只是为了避免在矩阵公式中反复书写\(\begin{bmatrix}x&y\end{bmatrix}^{\top}\) 而使用的简称。密度 \(f(z)\) 表示“在具体位置 \(z\) 处的密度”,其公式为

\[ f(z) =\frac{1}{2\pi\sqrt{\det\Sigma}} \exp\!\left[-\frac12(z-\mu)^\top\Sigma^{-1}(z-\mu)\right]. \tag{3.1} \]

因为 \(z\) 的两个坐标就是 \(x,y\),\(f(z)=f(x,y)\)。首先有

\[ \det\Sigma=\sigma_x^2\sigma_y^2(1-\rho^2), \]

把逆矩阵展开可得更熟悉的形式:

\[ \begin{aligned} D(x,y) ={}&\frac{(x-\mu_x)^2}{\sigma_x^2} -\frac{2\rho(x-\mu_x)(y-\mu_y)}{\sigma_x\sigma_y} +\frac{(y-\mu_y)^2}{\sigma_y^2},\\ f(x,y) ={}&\frac{1}{2\pi\sigma_x\sigma_y\sqrt{1-\rho^2}} \exp\!\left[-\frac{D(x,y)}{2(1-\rho^2)}\right]. \end{aligned} \tag{3.2} \]

3.2 密度前面的归一化常数

式 (3.1) 必须在整个平面上积分为 1。令

\[ L=\Sigma^{1/2}, \qquad v=L^{-1}(z-\mu), \]

这里 \(v\) 表示把点 \(z\) 先减去均值、再消除协方差尺度后得到的标准化坐标。于是 \(z=\mu+Lv\),并且

\[ (z-\mu)^\top\Sigma^{-1}(z-\mu) =v^\top L^\top\Sigma^{-1}Lv. \]

因为 \(L=L^\top\)、\(\Sigma=L^2\),所以 \(\Sigma^{-1}=L^{-2}\),从而

\[ L^\top\Sigma^{-1}L =LL^{-2}L=I, \]

即二次型变成 \(v^\top v=\|v\|_2^2\)。

令 \(z=\mu+Lv\)。

变量替换时的面积缩放因子的详细推导

先把矩阵和坐标全部展开:

\[ L= \begin{bmatrix}a&b\\c&d\end{bmatrix}, \qquad v= \begin{bmatrix}v_1\\v_2\end{bmatrix}, \qquad z= \begin{bmatrix}x\\y\end{bmatrix}. \]

由 \(z=\mu+Lv\) 可得

\[ x=\mu_x+av_1+bv_2, \qquad y=\mu_y+cv_1+dv_2. \]

写成矩阵形式

\[ \begin{pmatrix}x\\y\end{pmatrix} = \begin{pmatrix}\mu_x\\\mu_y\end{pmatrix} + \underbrace{\begin{pmatrix}a&b\\c&d\end{pmatrix}}_{L} \begin{pmatrix}v_1\\v_2\end{pmatrix} \]

加上 \(\mu\) 只会把所有点整体平移,不会改变边长或面积;真正决定面积缩放的是矩阵 \(L\)。

在 \((v_1,v_2)\) 平面取无穷小矩形:顶点 \((0,0),(\Delta v_1,0),(0,\Delta v_2),(\Delta v_1,\Delta v_2)\)。两条邻边向量为

\[ \boldsymbol{u}_1=\begin{pmatrix}\Delta v_1\\0\end{pmatrix},\quad \boldsymbol{u}_2=\begin{pmatrix}0\\\Delta v_2\end{pmatrix}. \]

原矩形面积为

\[ \Delta A_v = \Delta v_1 \Delta v_2. \]

经过线性变换 \(L\) 后的向量(\(xy\) 平面)为

\[ \boldsymbol{e}_1 = L\boldsymbol{u}_1 = \begin{pmatrix}a&b\\c&d\end{pmatrix}\begin{pmatrix}\Delta v_1\\0\end{pmatrix} = \begin{pmatrix}a\\c\end{pmatrix}\Delta v_1. \]
\[ \boldsymbol{e}_2 = L\boldsymbol{u}_2 = \begin{pmatrix}a&b\\c&d\end{pmatrix}\begin{pmatrix}0\\\Delta v_2\end{pmatrix} = \begin{pmatrix}b\\d\end{pmatrix}\Delta v_2. \]

矩形被线性映射为由 \(\boldsymbol{e}_1,\boldsymbol{e}_2\) 张成的平行四边形。平行四边形面积等于两个向量叉积的模长:

\[ \Delta A_{xy}= \big|\boldsymbol{e}_1 \times \boldsymbol{e}_2\big|. \]

再乘回 \(\Delta v_1,\Delta v_2\),变换后的微小面积就是

\[ \Delta A_z =|\det L|\,\Delta v_1\Delta v_2 =|\det L|\,\Delta A_v. \]

让小矩形的边长趋近于 0,就得到积分中的面积元关系

\[ \mathrm dz=|\det L|\,\mathrm dv. \]

用多元微积分的语言,式子

\[ \frac{\partial(x,y)}{\partial(v_1,v_2)} = \begin{bmatrix} \partial x/\partial v_1 & \partial x/\partial v_2\\ \partial y/\partial v_1 & \partial y/\partial v_2 \end{bmatrix} = \begin{bmatrix}a&b\\c&d\end{bmatrix} =L \]

叫作 Jacobian 矩阵。上面的几何推导正是在说明:变量替换公式为什么使用 Jacobian 行列式的绝对值。

这里 \(\mathrm dz\) 是二维面积元 \(\mathrm dx\,\mathrm dy\) 的简写,\(\mathrm dv\) 同样是\(\mathrm dv_1\,\mathrm dv_2\) 的简写;它们表示积分时取一个无限小的面积,不是新的随机变量。

最后说明为什么本节还能把 \(|\det L|\) 写成 \(\sqrt{\det\Sigma}\)。因为 \(L=\Sigma^{1/2}\),所以\(\Sigma=L^2\)。行列式的乘法性质给出

\[ \det\Sigma =\det(L^2) =\det(L)\det(L) =(\det L)^2. \]

本节假设 \(\Sigma\succ0\),它的主平方根 \(L\) 也正定,因此 \(\det L>0\)。于是

\[ |\det L|=\det L=\sqrt{\det\Sigma}. \]

两步合在一起,便得到原来的面积元公式:

\[ \boxed{ \mathrm dz=|\det L|\,\mathrm dv =\sqrt{\det\Sigma}\,\mathrm dv }. \]

现在从式 (3.1) 的原始密度开始,先把需要验证的总积分记为 \(I\):

\[ I :=\int_{\mathbb R^2}f(z)\,\mathrm dz. \]

把式 (3.1) 中的 \(f(z)\) 原样代入:

\[ I =\int_{\mathbb R^2} \frac{1}{2\pi\sqrt{\det\Sigma}} \exp\!\left[ -\frac12(z-\mu)^\top\Sigma^{-1}(z-\mu) \right] \mathrm dz. \]

变量替换 \(z=\mu+Lv\) 会同时改变下面四处:

  1. 向量差变为

    \[ z-\mu=(\mu+Lv)-\mu=Lv. \]
  2. 指数中的二次型变为

    \[ \begin{aligned} (z-\mu)^\top\Sigma^{-1}(z-\mu) &=(Lv)^\top\Sigma^{-1}(Lv)\\ &=v^\top L^\top\Sigma^{-1}Lv\\ &=v^\top Iv\\ &=v^\top v =\|v\|_2^2. \end{aligned} \]
  3. 面积元按照刚刚证明的公式变为

    \[ \mathrm dz=\sqrt{\det\Sigma}\,\mathrm dv. \]
  4. 因为 \(L\) 正定且可逆,\(v\) 遍历整个平面时,\(z=\mu+Lv\) 也恰好遍历整个平面,所以积分区域仍写作 \(\mathbb R^2\)。

把这四项同时代回 \(I\):

\[ \begin{aligned} I &=\int_{\mathbb R^2} \frac{1}{2\pi\sqrt{\det\Sigma}} \exp\!\left(-\frac{\|v\|_2^2}{2}\right) \underbrace{\sqrt{\det\Sigma}\,\mathrm dv}_{\mathrm dz}\\ &=\frac1{2\pi} \int_{\mathbb R^2} \exp\!\left(-\frac{\|v\|_2^2}{2}\right)\mathrm dv. \end{aligned} \]

第二行中,分母的 \(\sqrt{\det\Sigma}\) 与面积元带来的 \(\sqrt{\det\Sigma}\) 正好约掉。这就是Gaussian 密度分母必须包含这个因子的原因。

接着计算剩余的标准 Gaussian 积分。在 \(v\) 平面使用极坐标

\[ v_1=r\cos\varphi, \qquad v_2=r\sin\varphi, \]

其中半径 \(r\in[0,\infty)\),角度 \(\varphi\in[0,2\pi)\)。此时

\[ \|v\|_2^2 =v_1^2+v_2^2 =r^2\cos^2\varphi+r^2\sin^2\varphi =r^2. \]

极坐标的 Jacobian 矩阵为

\[ \frac{\partial(v_1,v_2)}{\partial(r,\varphi)} = \begin{bmatrix} \cos\varphi&-r\sin\varphi\\ \sin\varphi&r\cos\varphi \end{bmatrix}. \]

它的行列式是

\[ r\cos^2\varphi+r\sin^2\varphi=r\ge0, \]

所以面积元变为

\[ \mathrm dv=r\,\mathrm dr\,\mathrm d\varphi. \]

将 \(\|v\|_2^2=r^2\) 和面积元一起代入:

\[ \begin{aligned} I &=\frac1{2\pi} \int_0^{2\pi}\int_0^\infty e^{-r^2/2}r\,\mathrm dr\,\mathrm d\varphi\\ &=\frac1{2\pi} \left(\int_0^{2\pi}\mathrm d\varphi\right) \left(\int_0^\infty e^{-r^2/2}r\,\mathrm dr\right)\\ &=\frac{2\pi}{2\pi} \int_0^\infty e^{-r^2/2}r\,\mathrm dr. \end{aligned} \]

最后对径向积分作一维变量替换

\[ u=\frac{r^2}{2}, \qquad \mathrm du=r\,\mathrm dr. \]

当 \(r=0\) 时 \(u=0\),当 \(r\to\infty\) 时 \(u\to\infty\),因此

\[ \begin{aligned} I &=\int_0^\infty e^{-u}\,\mathrm du\\ &=\left[-e^{-u}\right]_{0}^{\infty}\\ &=0-(-1)\\ &=1. \end{aligned} \]

所以式 (3.1) 确实满足概率密度的归一化要求:

\[ \boxed{ \int_{\mathbb R^2}f(z)\,\mathrm dz=1 }. \]

这同时解释了分母中的两部分:\(2\pi\) 归一化二维标准 Gaussian,\(\sqrt{\det\Sigma}\) 抵消\(L=\Sigma^{1/2}\) 对面积的缩放。

3.3 等密度线是椭圆

式 (3.1) 的密度只由二次型

\[ r^2=(z-\mu)^\top\Sigma^{-1}(z-\mu) \]

决定。因为本节讨论具有普通二维密度的 Gaussian,所以 \(\Sigma\succ0\),两个特征值都严格大于 0。 将协方差写成特征分解

\[ \Sigma=R \begin{bmatrix}\lambda_1&0\\0&\lambda_2\end{bmatrix} R^\top, \qquad \lambda_1>0, \quad \lambda_2>0, \]

为了看清后续矩阵运算,暂时把中间的对角矩阵记为

\[ D= \begin{bmatrix}\lambda_1&0\\0&\lambda_2\end{bmatrix}, \]

于是 \(\Sigma=RDR^\top\)。矩阵 \(R\) 的列是单位正交特征向量,因此

\[ R^\top R=RR^\top=I, \qquad R^{-1}=R^\top. \]

先推导协方差的逆矩阵。由于 \(\lambda_1,\lambda_2>0\),对角矩阵 \(D\) 可逆,并且

\[ D^{-1} = \begin{bmatrix} 1/\lambda_1&0\\ 0&1/\lambda_2 \end{bmatrix}. \]

候选逆矩阵是 \(RD^{-1}R^\top\)。直接相乘验证:

\[ \begin{aligned} (RDR^\top)(RD^{-1}R^\top) &=RD\underbrace{(R^\top R)}_{I}D^{-1}R^\top\\ &=R\underbrace{DD^{-1}}_{I}R^\top\\ &=RR^\top\\ &=I. \end{aligned} \]

反向相乘同样得到 \(I\),所以

\[ \Sigma^{-1}=RD^{-1}R^\top. \]

现在定义

\[ q=R^\top(z-\mu) = \begin{bmatrix}q_1\\q_2\end{bmatrix}. \]

\(z-\mu\) 是点 \(z\) 相对中心 \(\mu\) 的位移;左乘 \(R^\top\) 相当于把这个位移旋转到协方差的两条特征向量方向。因此 \(q_1,q_2\) 就是该位移沿两条主轴的坐标。

由矩阵转置规则 \((AB)^\top=B^\top A^\top\),可得

\[ q^\top =\left[R^\top(z-\mu)\right]^\top =(z-\mu)^\top R. \]

把 \(\Sigma^{-1}=RD^{-1}R^\top\) 代回二次型:

\[ \begin{aligned} r^2 &=(z-\mu)^\top\Sigma^{-1}(z-\mu)\\ &=(z-\mu)^\top RD^{-1}R^\top(z-\mu)\\ &=q^\top D^{-1}q. \end{aligned} \]

最后把对角矩阵乘法逐项展开:

\[ \begin{aligned} q^\top D^{-1}q &= \begin{bmatrix}q_1&q_2\end{bmatrix} \begin{bmatrix} 1/\lambda_1&0\\ 0&1/\lambda_2 \end{bmatrix} \begin{bmatrix}q_1\\q_2\end{bmatrix}\\ &= \begin{bmatrix}q_1&q_2\end{bmatrix} \begin{bmatrix}q_1/\lambda_1\\q_2/\lambda_2\end{bmatrix}\\ &=\frac{q_1^2}{\lambda_1}+\frac{q_2^2}{\lambda_2}. \end{aligned} \]

因此

\[ r^2=\frac{q_1^2}{\lambda_1}+\frac{q_2^2}{\lambda_2}. \tag{3.3} \]

固定一个 \(r>0\),再把等式两边除以 \(r^2\):

\[ \frac{q_1^2}{r^2\lambda_1} +\frac{q_2^2}{r^2\lambda_2} =1, \]

也就是

\[ \frac{q_1^2}{\left(r\sqrt{\lambda_1}\right)^2} +\frac{q_2^2}{\left(r\sqrt{\lambda_2}\right)^2} =1. \]

这正是标准椭圆方程,因此在 \(q\) 坐标系中的两条半轴分别为\(r\sqrt{\lambda_1}\)、\(r\sqrt{\lambda_2}\)。又因为

\[ q=R^\top(z-\mu) \iff z=\mu+Rq, \]

\(R\) 把主轴坐标系中的椭圆旋转回原坐标系,\(\mu\) 再把椭圆中心平移到 Gaussian 的均值位置。因此:

  • 均值 \(\mu\) 对应框中心;
  • 协方差的特征向量对应框的两个方向;
  • 特征值平方根对应两个方向上的尺度。

一个常见疑问:\(f(z)\) 中的指数函数和前面的系数去哪里了?

它们并没有被丢掉。对同一个 Gaussian,\(\mu\) 和 \(\Sigma\) 已经固定,因此

\[ \frac{1}{2\pi\sqrt{\det\Sigma}} \]

是一个与位置 \(z\) 无关的正常数。若把某条等密度线的固定密度值记为 \(f_0\),其中 \(0<f_0\le 1/(2\pi\sqrt{\det\Sigma})\),则由式 (3.1) 有

\[ f_0 =\frac{1}{2\pi\sqrt{\det\Sigma}}e^{-r^2/2}. \]

移项并取自然对数:

\[ e^{-r^2/2}=2\pi\sqrt{\det\Sigma}\,f_0 \quad\Longrightarrow\quad r^2=-2\log\!\left(2\pi\sqrt{\det\Sigma}\,f_0\right). \]

固定密度值 \(f_0\) 后,右边是常数,所以等密度线仍然等价于“\(r^2\) 固定”。前面的系数只决定密度数值\(f_0\) 与半径 \(r\) 怎样对应;\(e^{-r^2/2}\) 又随 \(r^2\) 严格减小,只把二次型数值转换成密度高低。二者都不会改变等密度线是椭圆这一结论。不过在比较两个不同的 Gaussian 密度数值时,\(\Sigma\) 可能不同,前面的系数也会不同,此时不能把它省略。

3.4 水平框怎样变成 Gaussian

一个水平框记作

\[ B=(c_x,c_y,w,h), \]

其中 \(B\) 表示 bounding box,\((c_x,c_y)\) 是框中心的横、纵坐标,\(w>0\) 是框宽,\(h>0\) 是框高。这里要做的是把四个框参数确定地编码成一个二维 Gaussian 的均值 \(\mu\) 和协方差 \(\Sigma\)。这只是几何表示,不是说框内像素真实服从 Gaussian,也不是网络在预测定位不确定性。

第一步:让 Gaussian 中心等于框中心

框中心已经给出,所以直接取

\[ \mu= \begin{bmatrix}c_x\\c_y\end{bmatrix}. \]

第二步:写出轴对齐协方差的一般形式

水平框的两条轴分别与图像横轴、纵轴平行,不需要旋转。因此令两个坐标方向不相关,把协方差写成

\[ \Sigma= \begin{bmatrix} \sigma_x^2&0\\ 0&\sigma_y^2 \end{bmatrix}. \]

这里 \(\sigma_x>0\)、\(\sigma_y>0\) 分别是 Gaussian 沿横轴和纵轴的标准差;协方差矩阵中存放的是 方差,所以对角元素是 \(\sigma_x^2,\sigma_y^2\)。

前面已经定义,任取平面点

\[ z= \begin{bmatrix}x\\y\end{bmatrix}, \]

其中小写 \(x,y\) 是该点的横、纵坐标。点 \(z\) 的 Mahalanobis 半径满足

\[ r^2=(z-\mu)^\top\Sigma^{-1}(z-\mu). \]

这里的 \(r\) 就是 3.3 节一直使用的半径,不是新引入的框参数。因为

\[ z-\mu = \begin{bmatrix}x-c_x\\y-c_y\end{bmatrix}, \qquad \Sigma^{-1} = \begin{bmatrix} 1/\sigma_x^2&0\\ 0&1/\sigma_y^2 \end{bmatrix}, \]

逐项相乘得到

\[ \begin{aligned} r^2 &= \begin{bmatrix}x-c_x&y-c_y\end{bmatrix} \begin{bmatrix} 1/\sigma_x^2&0\\ 0&1/\sigma_y^2 \end{bmatrix} \begin{bmatrix}x-c_x\\y-c_y\end{bmatrix}\\ &=\frac{(x-c_x)^2}{\sigma_x^2} +\frac{(y-c_y)^2}{\sigma_y^2}. \end{aligned} \]

第三步:让 \(r=1\) 等密度椭圆成为框的内切椭圆

取 \(r=1\) 后,上式变成

\[ \frac{(x-c_x)^2}{\sigma_x^2} +\frac{(y-c_y)^2}{\sigma_y^2} =1. \]

这条椭圆以 \((c_x,c_y)\) 为中心,横、纵半轴分别为 \(\sigma_x,\sigma_y\)。水平矩形的内切椭圆与矩形 中心相同,横半轴是宽度的一半 \(w/2\),纵半轴是高度的一半 \(h/2\),其方程为

\[ \frac{(x-c_x)^2}{(w/2)^2} +\frac{(y-c_y)^2}{(h/2)^2} =1. \]

要让两条椭圆完全相同,只需逐项比较分母:

\[ \sigma_x^2=(w/2)^2=\frac{w^2}{4}, \qquad \sigma_y^2=(h/2)^2=\frac{h^2}{4}. \]

因此 NWD 使用的水平框 Gaussian 编码为2

\[ \mu= \begin{bmatrix}c_x\\c_y\end{bmatrix}, \qquad \Sigma= \begin{bmatrix} w^2/4&0\\0&h^2/4 \end{bmatrix}. \tag{3.4} \]

最后从式 (3.4) 直接代回验证。协方差的逆为

\[ \Sigma^{-1} = \begin{bmatrix} 4/w^2&0\\ 0&4/h^2 \end{bmatrix} = \begin{bmatrix} 1/(w/2)^2&0\\ 0&1/(h/2)^2 \end{bmatrix}. \]

所以

\[ \begin{aligned} (z-\mu)^\top\Sigma^{-1}(z-\mu) &= \begin{bmatrix}x-c_x&y-c_y\end{bmatrix} \begin{bmatrix} 1/(w/2)^2&0\\ 0&1/(h/2)^2 \end{bmatrix} \begin{bmatrix}x-c_x\\y-c_y\end{bmatrix}\\ &=\frac{(x-c_x)^2}{(w/2)^2} +\frac{(y-c_y)^2}{(h/2)^2}. \end{aligned} \]

令这个二次型等于 1,恰好重新得到矩形内切椭圆方程,验证完成。

“一个标准差椭圆”包含多少概率质量

把 \(r=1\) 椭圆称作“\(1\sigma\) 椭圆”只是一种尺度说法,因为它的两条半轴分别等于两个方向的一个标准差。它并不表示二维 Gaussian 有 100% 的概率质量落在椭圆内,也不能直接套用一维正态分布的“均值左右一个标准差”结论。

3.2 节已经把 Gaussian 标准化,并在标准化平面中使用极坐标。沿用那里定义的半径 \(r\) 和极角\(\varphi\),椭圆内部对应 \(0\le r\le1\)。直接把径向积分的上限从 \(\infty\) 改成 1:

\[ \begin{aligned} \Pr(r\le1) &=\frac1{2\pi} \int_0^{2\pi}\int_0^1 e^{-r^2/2}r\,\mathrm dr\,\mathrm d\varphi\\ &=\int_0^1 e^{-r^2/2}r\,\mathrm dr\\ &=\left[-e^{-r^2/2}\right]_{0}^{1}\\ &=1-e^{-1/2}\\ &\approx0.393. \end{aligned} \]

因此内切椭圆只包含约 \(39.3\%\) 的概率质量。这个数说的是椭圆内部,不是整个矩形内部。Gaussian 在整个平面上都有非零密度,所以无论是椭圆还是有限大小的矩形,都不可能包含 100% 的概率质量。

为什么有时还会看到 \(w^2/12\)

\(w^2/4\) 来自“让一个标准差等于半框宽”的几何编码。另一种常见建模是假设一维位置在宽度为 \(w\) 的 线段内均匀分布。为避免与 Gaussian 随机向量 \(X\) 混淆,把这个一维随机位置记为 \(U\):

\[ U\sim\operatorname{Unif}\!\left[-\frac w2,\frac w2\right]. \]

\(\operatorname{Unif}[a,b]\) 表示在区间 \([a,b]\) 上均匀分布,其中 \(a,b\) 分别是区间的左、右端点。 这里区间长度是 \(w\),所以 \(U\) 的密度为

\[ p_U(u)= \begin{cases} 1/w,&-w/2\le u\le w/2,\\ 0,&\text{其他位置}. \end{cases} \]

大写 \(U\) 表示随机变量,小写 \(u\) 表示积分时枚举的一个具体位置。由于区间关于 0 对称,均值为

\[ \begin{aligned} \mathbb E[U] &=\frac1w\int_{-w/2}^{w/2}u\,\mathrm du\\ &=\frac1w\left[\frac{u^2}{2}\right]_{-w/2}^{w/2}\\ &=0. \end{aligned} \]

再从方差的原始定义开始:

\[ \begin{aligned} \operatorname{Var}(U) &=\mathbb E\!\left[(U-\mathbb E[U])^2\right]\\ &=\mathbb E[U^2] =\frac1w\int_{-w/2}^{w/2}u^2\,\mathrm du\\ &=\frac1w\left[\frac{u^3}{3}\right]_{-w/2}^{w/2}. \end{aligned} \]

上下限代入后,

\[ \begin{aligned} \operatorname{Var}(U) &=\frac1w \frac{(w/2)^3-(-w/2)^3}{3}\\ &=\frac1w\frac{2(w/2)^3}{3}\\ &=\frac{w^2}{12}. \end{aligned} \]

纵轴方向把 \(w\) 换成 \(h\),同理得到方差 \(h^2/12\)。因此:

  • \(w^2/12,h^2/12\) 是“框内位置服从均匀分布”时的真实二阶矩;
  • \(w^2/4,h^2/4\) 是 NWD/GWD 为了让 \(r=1\) 椭圆成为内切椭圆而选取的几何编码。

两者来自不同建模目标,不能在实现中无说明地混用。NWD/GWD 的框到 Gaussian 映射采用后者,并不 声称框内像素或目标位置真实服从 Gaussian12。

3.5 旋转框怎样变成 Gaussian

对旋转框

\[ B=(c_x,c_y,w,h,\theta), \]

定义

\[ R_\theta= \begin{bmatrix} \cos\theta&-\sin\theta\\ \sin\theta&\cos\theta \end{bmatrix}, \qquad S=\begin{bmatrix}w/2&0\\0&h/2\end{bmatrix}. \]

GWD 论文先写协方差的主平方根1

\[ \Sigma^{1/2}=R_\theta S R_\theta^\top, \]

所以真正的协方差是

\[ \Sigma =R_\theta S^2R_\theta^\top =R_\theta \begin{bmatrix}w^2/4&0\\0&h^2/4\end{bmatrix} R_\theta^\top. \tag{3.5} \]

逐项相乘:

\[ \Sigma= \begin{bmatrix} \frac{w^2}{4}\cos^2\theta+\frac{h^2}{4}\sin^2\theta &\frac{w^2-h^2}{4}\sin\theta\cos\theta\\ \frac{w^2-h^2}{4}\sin\theta\cos\theta &\frac{w^2}{4}\sin^2\theta+\frac{h^2}{4}\cos^2\theta \end{bmatrix}. \tag{3.6} \]

当 \(\theta=0\) 时,式 (3.5) 就退化为水平框的式 (3.4)。
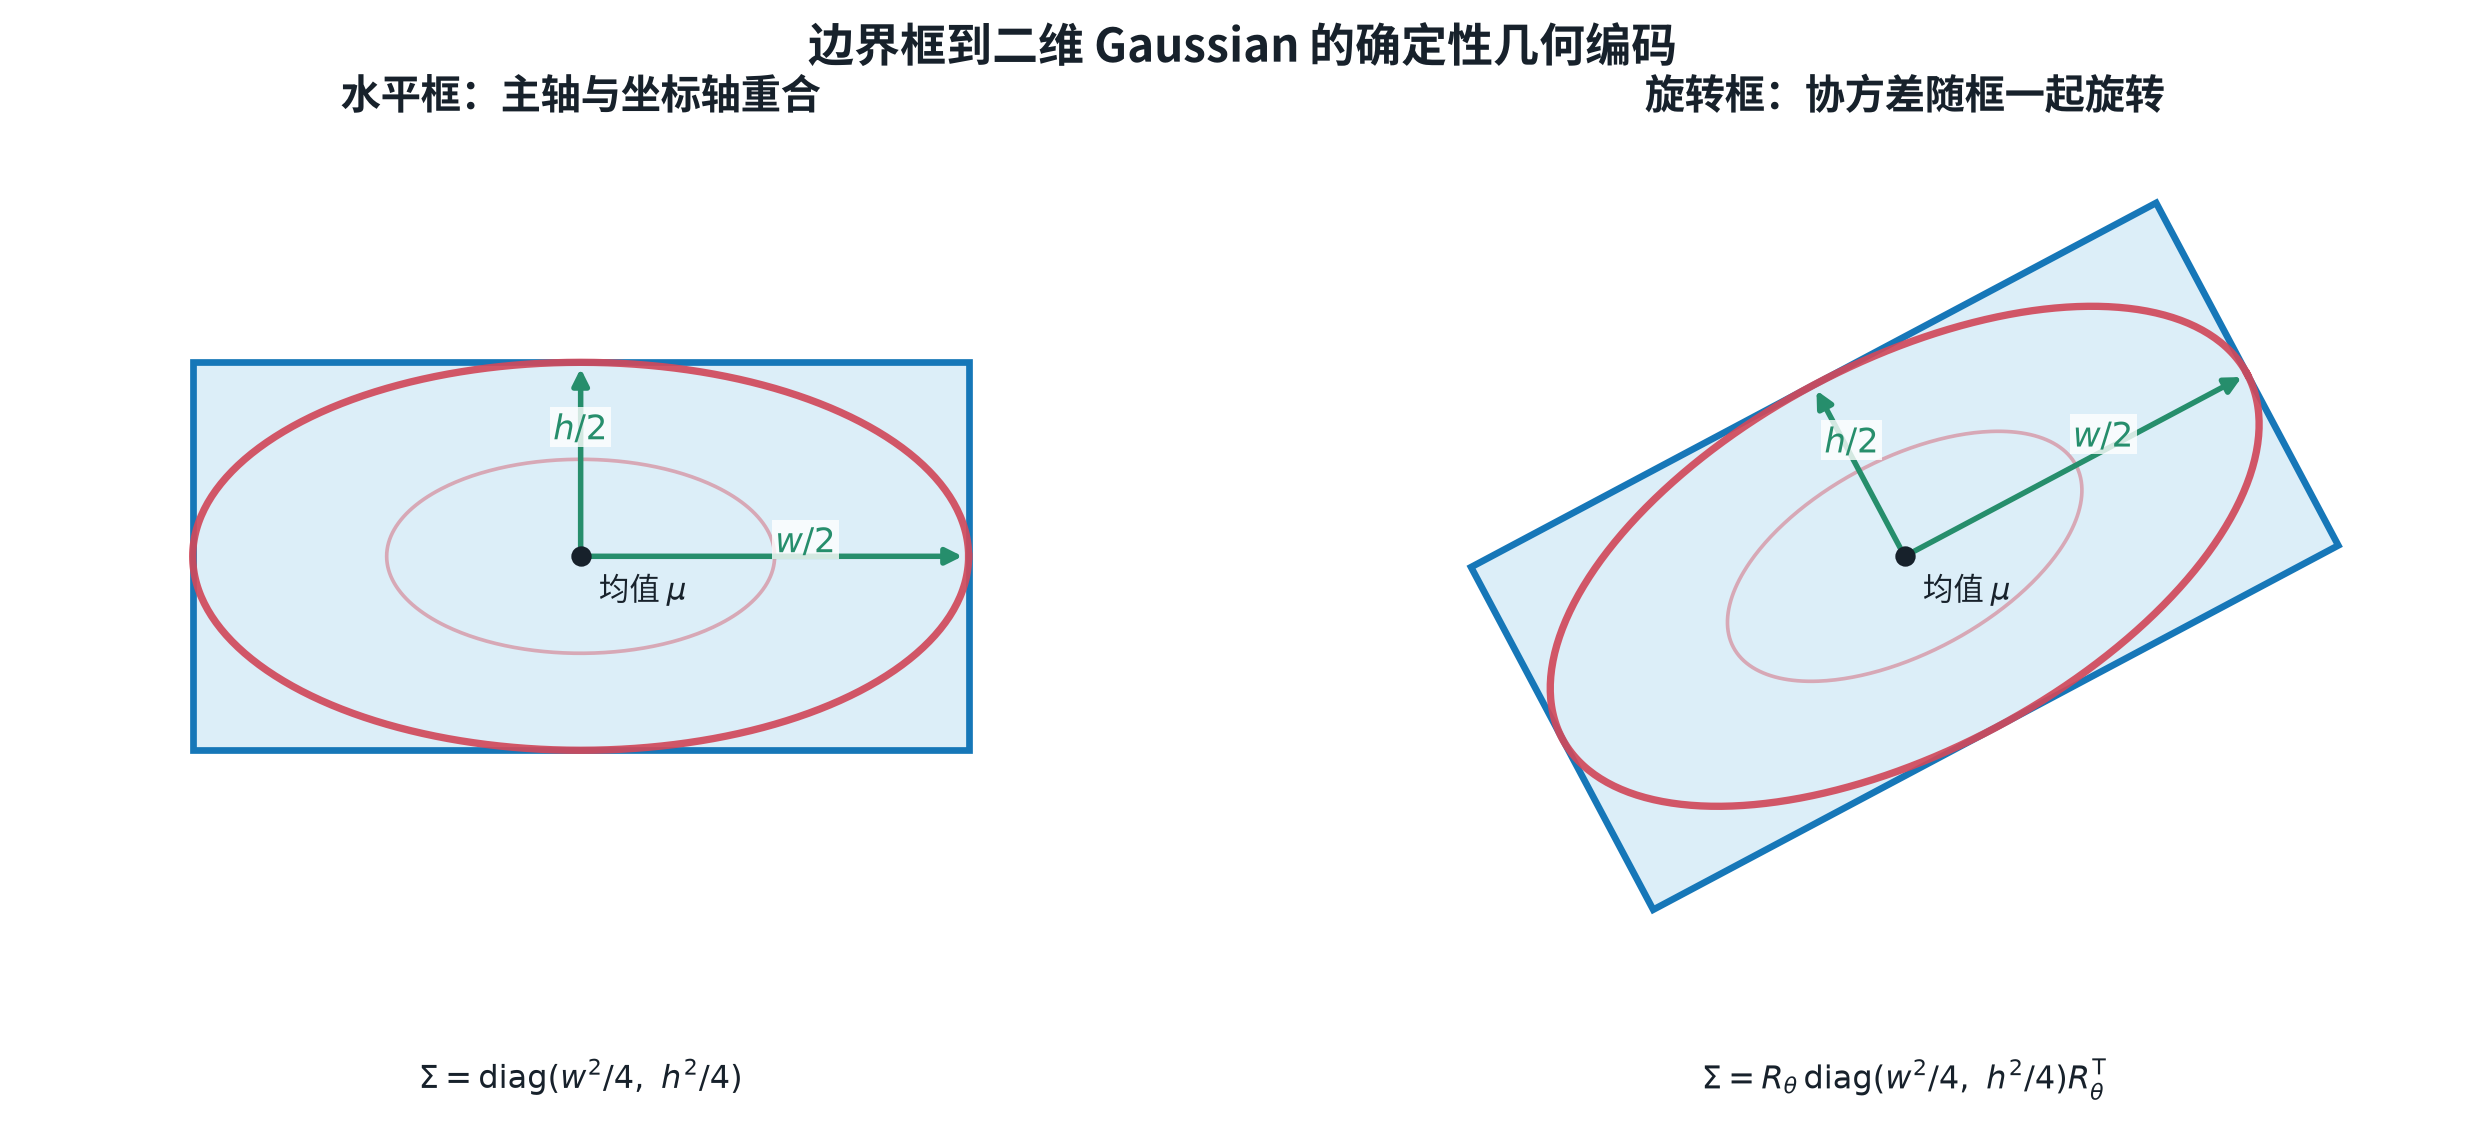
图 3-1:水平框和旋转框到二维 Gaussian 的映射。红色曲线是 \(r=1\) 的等密度椭圆;Gaussian 是框参数的确定性编码。图为本文绘制。

四、两个 Gaussian 之间的 \(W_2\):从定义推到闭式

现在推导全文的核心公式。设

\[ P=\mathcal N(\mu_1,\Sigma_1), \qquad Q=\mathcal N(\mu_2,\Sigma_2). \]

在开始矩阵推导前,先把第 2 节的运输定义接回来。这里最重要的是分清四个对象:

  • \(P\) 是源分布,规定质量从哪些位置出发;
  • \(Q\) 是目标分布,规定质量最终到哪些位置;
  • \(X\) 是随机选中一小份质量后,记录到的出发位置;
  • \(Y\) 是同一份质量的到达位置。

因此 \(X,Y\) 不是两个完整分布,而是一对随机位置。它们分别满足 \(X\sim P\)、\(Y\sim Q\)。只规定这两个 边缘分布还没有说明“哪个出发位置与哪个到达位置配成一对”;这部分由耦合 \(\gamma\) 决定。

假设某次按照耦合 \(\gamma\) 随机选中一小份质量,它从位置 \(X\) 运到位置 \(Y\)。那么

\[ X-Y \]

是这份质量的位移向量。用 \(Y-X\) 也可以,因为二者只差一个负号,长度相同。位移的欧氏长度为

\[ \|X-Y\|_2. \]

范数右下角的 2 表示使用欧氏距离。本文研究二阶 Wasserstein 距离,所以把一单位质量走这条路线的成本定义为距离的平方:

\[ \|X-Y\|_2^2. \]

为什么不直接计算 \(\mathbb E[X-Y]\)?因为位移有方向,相反方向会互相抵消。例如一半质量向左移动 1,另一半质量向右移动 1,平均位移是 0,但所有质量显然都发生了运输。先取范数或平方后,每条路线 的成本都非负,向左和向右便不会抵消。因此两种计算的区别是

\[ \underbrace{ \mathbb E\!\left[\|X-Y\|_2^2\right] }_{\text{先算每条路线的非负成本,再平均:这是需要的量}} \qquad\ne\qquad \underbrace{ \left\|\mathbb E[X-Y]\right\|_2^2 }_{\text{先平均有方向的位移:会发生抵消}}. \]

这里右上角的 2 才表示平方。因为 \(X,Y\) 会随随机选中的质量而变化,所以\(\|X-Y\|_2^2\) 也是一个随机量:有的质量走得近,成本小;有的质量走得远,成本大。单独看某一次取值不能代表整个运输方案,必须把所有路线的成本按各自运输质量加权平均。这个加权平均就是期望

\[ \mathbb E_\gamma\!\left[\|X-Y\|_2^2\right]. \]

下标 \(\gamma\) 表示“概率权重由当前耦合 \(\gamma\) 决定”。它不是一个新的乘数,也不是对 \(\gamma\)求期望。

在离散例子中,期望就是运输总代价;回忆第 2 节的例子:源分布在位置 0、4 各有 \(1/2\) 质量,目标分布在位置 1、3 各需要 \(1/2\) 质量。离散耦合的矩阵元素 \(\gamma_{ij}\) 表示从源位置 \(x_i\) 运到目标位置 \(y_j\) 的质量。现在把总质量看成总概率 1,则

\[ \Pr(X=x_i,\,Y=y_j)=\gamma_{ij}. \]

按照离散随机变量期望的定义,“取值乘以该取值出现的概率,再全部相加”,有

\[ \boxed{ \mathbb E_\gamma\!\left[\|X-Y\|_2^2\right] =\sum_i\sum_j \underbrace{\|x_i-y_j\|_2^2}_{\text{路线 }x_i\to y_j\text{ 的单位成本}} \underbrace{\gamma_{ij}}_{\text{走这条路线的质量,也就是概率}} }. \]

右边正是第 2 节定义的运输总代价

\[ \operatorname{Cost}(\Gamma) =\sum_i\sum_j c_{ij}\gamma_{ij}, \qquad c_{ij}=\|x_i-y_j\|_2^2. \]

也就是说,期望不是额外添加的统计技巧;它就是“单位成本乘以运输质量后求和”的概率写法。

以近邻耦合为例,只有两条路线的概率不为 0:

\[ \Pr(X=0,Y=1)=\frac12, \qquad \Pr(X=4,Y=3)=\frac12. \]

下面期望符号的下标 \(\mathrm{near}\) 表示权重来自近邻耦合 \(\Gamma_{\mathrm{near}}\);类似地,\(\mathrm{cross}\) 和 \(\mathrm{ind}\) 分别表示交叉耦合与独立耦合。

所以

\[ \begin{aligned} \mathbb E_{\mathrm{near}}\!\left[|X-Y|^2\right] &=\frac12|0-1|^2+\frac12|4-3|^2\\ &=\frac12+\frac12\\ &=1. \end{aligned} \]

这里位置是一维数字,所以使用绝对值 \(|X-Y|\);进入二维平面后,同一个写法要换成向量的欧氏范数\(\|X-Y\|_2\)。交叉耦合的期望为

\[ \mathbb E_{\mathrm{cross}}\!\left[|X-Y|^2\right] =\frac12|0-3|^2+\frac12|4-1|^2 =9, \]

独立耦合则为

\[ \mathbb E_{\mathrm{ind}}\!\left[|X-Y|^2\right] =\frac14(1+9+9+1) =5. \]

三个耦合拥有完全相同的 \(P,Q\),期望运输成本却分别为 1、9、5。这说明只计算某一个任意耦合的期望还不够;Wasserstein 距离要在所有合法耦合中挑选期望成本最小的一个。

Gaussian 是连续分布,无法把所有可能路线列成有限张表,但含义完全相同。耦合 \(\gamma\) 规定每一对 出发位置和到达位置获得多少概率权重;期望把所有路线的平方距离按这些权重平均:

\[ \mathbb E_\gamma\!\left[\|X-Y\|_2^2\right] =\int_{\mathbb R^d\times\mathbb R^d} \|x-y\|_2^2\,\mathrm d\gamma(x,y). \]

这条公式中,小写 \(x,y\) 分别表示 \(X,Y\) 的一次具体取值;它们各自都是 \(d\) 维位置。目标检测在图像平面中使用 \(d=2\)。\(\mathrm d\gamma(x,y)\) 表示每对位置的权重由耦合 \(\gamma\) 给出。

因此二阶 Wasserstein 距离的平方按照定义就是

\[ \boxed{ W_2^2(P,Q) =\inf_{\gamma\in\Pi(P,Q)} \mathbb E_\gamma\!\left[\|X-Y\|_2^2\right] }. \tag{4.0} \]

从内到外读这条公式:

  1. 选定一个合法耦合 \(\gamma\);
  2. 计算每一份质量的平方运输距离 \(\|X-Y\|_2^2\);
  3. 对所有质量取加权平均,得到该耦合的期望成本;
  4. 让 \(\gamma\) 遍历所有合法耦合 \(\Pi(P,Q)\),取其中的下确界。

在本文的 Gaussian 情形,后面会构造出达到下确界的耦合,所以这里的 \(\inf\) 最终确实会被某个最优耦合取到。

\(W_1\)、\(W_2^2\) 与 \(W_2\) 不要混淆

一维情况下常写的 \(\mathbb E|X-Y|\) 对应一阶运输成本。严格地区分:

\[ \begin{aligned} W_1(P,Q) &=\inf_{\gamma\in\Pi(P,Q)} \mathbb E_\gamma\!\left[\|X-Y\|_2\right],\\ W_2^2(P,Q) &=\inf_{\gamma\in\Pi(P,Q)} \mathbb E_\gamma\!\left[\|X-Y\|_2^2\right],\\ W_2(P,Q) &=\sqrt{W_2^2(P,Q)}. \end{aligned} \]

所以本节真正展开的是 \(\mathbb E\|X-Y\|_2^2\),不是 \(\mathbb E\|X-Y\|_2\)。使用平方成本是因为我们选择了 \(p=2\) 的 Wasserstein 距离;它会更强地惩罚远距离运输,并使 Gaussian 情形得到可以用均值和协方差表示的闭式。推导时直接处理 \(W_2^2\),还可以避免在每一步都携带最外层平方根。

现在再看两个 Gaussian 的闭式,式中出现均值差和协方差项就不再是另起炉灶:它们都来自对上述最小期望平方运输成本的展开。

这一闭式由 Dowson--Landau、Olkin--Pukelsheim、Givens--Shortt 等工作建立647;本文还用Chafaï 的教学性证明梳理8交叉核对推导路线,但定理依据仍以前述原始论文为准。结论是

\[ \boxed{ W_2^2(P,Q) =\|\mu_1-\mu_2\|_2^2 +\operatorname{Tr}\!\left[ \Sigma_1+\Sigma_2 -2\left(\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}\right)^{1/2} \right]. } \tag{4.1} \]

后面的任务是说明式 (4.1) 的每一项从哪里来,以及为什么它真的是所有耦合中的最小值。

4.1 第一步:把均值平移和形状变化分开

任选一个耦合 \((X,Y)\),满足

\[ X\sim\mathcal N(\mu_1,\Sigma_1), \qquad Y\sim\mathcal N(\mu_2,\Sigma_2). \]

令中心化变量

\[ \bar X=X-\mu_1, \qquad \bar Y=Y-\mu_2. \]

于是

\[ X-Y=(\mu_1-\mu_2)+(\bar X-\bar Y). \]

展开平方:

\[ \begin{aligned} \mathbb E\|X-Y\|_2^2 ={}&\|\mu_1-\mu_2\|_2^2 +\mathbb E\|\bar X-\bar Y\|_2^2\\ &+2(\mu_1-\mu_2)^\top\mathbb E[\bar X-\bar Y]. \end{aligned} \]

中心化后 \(\mathbb E[\bar X]=\mathbb E[\bar Y]=0\),所以最后的交叉项为 0:

\[ \mathbb E\|X-Y\|_2^2 =\|\mu_1-\mu_2\|_2^2 +\mathbb E\|\bar X-\bar Y\|_2^2. \tag{4.2} \]

第一项只取决于两个均值,无法由耦合改变。真正需要优化的是中心化变量的配对方式。

4.2 第二步:把中心化运输成本写成迹

对当前选定的耦合 \(\gamma\),定义交叉协方差

\[ C_\gamma :=\mathbb E_\gamma[\bar X\bar Y^\top]. \]

这里需要区分三层对象:

  • \(\bar X,\bar Y\) 是随机向量;
  • \(\bar X\bar Y^\top\) 是每次抽到一对 \((\bar X,\bar Y)\) 后得到的随机矩阵;
  • \(C_\gamma\) 是对这个随机矩阵取期望后的确定性 \(d\times d\) 矩阵。

符号中的两处下标含义不同:

  • \(C_\gamma\) 右下角的 \(\gamma\) 表示“按照哪一种联合分布,也就是哪一种配对规律来计算期望”;它不是矩阵的行号或列号;
  • 若再写矩阵元素 \((C_\gamma)_{ij}\),那么 \(i,j\) 才分别是行号和列号,并且
\[ (C_\gamma)_{ij} =\mathbb E_\gamma[(X_i-\mu_{1,i})(Y_j-\mu_{2,j})]. \]

因此,\(C_\gamma\) 可以读作“耦合 \(\gamma\) 所产生的交叉协方差矩阵”。边缘分布只规定 \(X\) 单独看服从什么分布、\(Y\) 单独看服从什么分布;耦合 \(\gamma\) 还规定每个 \(X\) 如何与一个 \(Y\) 配成一对。

用一维例子最容易看出下标 \(\gamma\) 的作用。固定

\[ X\sim\mathcal N(0,1), \qquad Y\sim\mathcal N(0,1). \]

下面三种配对都没有改变这两个边缘分布,但会产生不同的交叉协方差:

耦合,也就是配对方法 \(XY\) \(C_\gamma=\mathbb E_\gamma[XY]\)
总是令 \(Y=X\) \(X^2\) \(1\)
总是令 \(Y=-X\) \(-X^2\) \(-1\)
让 \(X,Y\) 相互独立 平均后正负抵消 \(0\)

所以不能只写“由 \(X\) 的分布和 \(Y\) 的分布确定的 \(C\)”:同样的两个边缘分布,在不同耦合下可以得到不同的 \(C_\gamma\)。下标 \(\gamma\) 正是在记录这个区别。

为避免后面每条公式都携带下标,本章讨论任意一个当前耦合时简写

\[ C:=C_\gamma. \]

本节其余未标下标的期望,也都按照当前耦合 \(\gamma\) 计算。

由 \(\|v\|_2^2=v^\top v\),

\[ \begin{aligned} \mathbb E\|\bar X-\bar Y\|_2^2 ={}&\mathbb E[\bar X^\top\bar X] +\mathbb E[\bar Y^\top\bar Y] -2\mathbb E[\bar X^\top\bar Y]. \end{aligned} \]

对任意随机向量 \(Z\),标量 \(Z^\top Z\) 等于矩阵 \(ZZ^\top\) 的迹,因此

\[ \mathbb E[\bar X^\top\bar X] =\operatorname{Tr}(\mathbb E[\bar X\bar X^\top]) =\operatorname{Tr}(\Sigma_1). \]

同理,

\[ \mathbb E[\bar Y^\top\bar Y]=\operatorname{Tr}(\Sigma_2), \qquad \mathbb E[\bar X^\top\bar Y]=\operatorname{Tr}(C). \]

所以

\[ \mathbb E\|\bar X-\bar Y\|_2^2 =\operatorname{Tr}(\Sigma_1)+\operatorname{Tr}(\Sigma_2) -2\operatorname{Tr}(C). \tag{4.3} \]

\(\Sigma_1,\Sigma_2\) 已固定。最小化式 (4.3),等价于在所有可行耦合中最大化\(\operatorname{Tr}(C)\)。

4.3 第三步:把“合法耦合”翻译成 \(C\) 的约束

4.2 节已经得到

\[ \mathbb E\|\bar X-\bar Y\|_2^2 =\operatorname{Tr}(\Sigma_1)+\operatorname{Tr}(\Sigma_2)-2\operatorname{Tr}(C). \]

\(\Sigma_1,\Sigma_2\) 由两个边缘 Gaussian 固定,因此下一步似乎只要让 \(\operatorname{Tr}(C)\) 尽量大。 但 \(C\) 不能任意选择:若把 \(C\) 的元素无限放大,式 (4.3) 甚至会给出负的平方距离期望,这显然不可能。

所以本节只解决一个问题:

在 \(\bar X\sim\mathcal N(0,\Sigma_1)\)、\(\bar Y\sim\mathcal N(0,\Sigma_2)\) 已固定时,给定一个候选 矩阵 \(C\),是否存在合法耦合 \(\gamma\),使 \(C=C_\gamma=\mathbb E_\gamma[\bar X\bar Y^\top]\)?

本节的最终答案将是:能被某个合法耦合产生的候选矩阵 \(C\),恰好都能写成

\[ C=\Sigma_1^{1/2}K\Sigma_2^{1/2}, \]

其中 \(K\) 是一个不会把向量长度放大的矩阵。4.4 节只需在这些 \(K\) 中继续最大化 \(\operatorname{Tr}(C)\)。

先用一维情形预演答案

若 \(\bar X,\bar Y\) 都是一维变量,设

\[ \operatorname{Var}(\bar X)=\sigma_1^2, \qquad \operatorname{Var}(\bar Y)=\sigma_2^2, \qquad \operatorname{Cov}(\bar X,\bar Y)=c. \]

这里 \(c\) 是一维交叉协方差。Cauchy--Schwarz 不等式给出

\[ |c| =|\mathbb E[\bar X\bar Y]| \le \sqrt{\mathbb E[\bar X^2]} \sqrt{\mathbb E[\bar Y^2]} =\sigma_1\sigma_2. \]

因此一维交叉协方差不可能无限大。将两边的尺度除掉,定义

\[ k=\frac{c}{\sigma_1\sigma_2}, \]

便得到熟悉的相关系数约束 \(|k|\le1\),并且

\[ c=\sigma_1k\sigma_2. \]

多维公式 \(C=\Sigma_1^{1/2}K\Sigma_2^{1/2}\) 正是这条一维公式的矩阵版本;\(K\) 是去掉两边尺度后的“矩阵相关系数”。下面证明它。

** 第一步:把两个随机向量放进同一个协方差矩阵 **

已有定义是

\[ \mathbb E[\bar X]=\mathbb E[\bar Y]=0, \qquad \Sigma_1=\mathbb E[\bar X\bar X^\top], \qquad \Sigma_2=\mathbb E[\bar Y\bar Y^\top], \]
\[ C=\mathbb E[\bar X\bar Y^\top]. \]

将两个 \(d\times1\) 列向量上下拼接,得到联合随机向量

\[ \begin{bmatrix}\bar X\\\bar Y\end{bmatrix} \in\mathbb R^{2d}. \]

它的均值为 0,所以协方差就是外积的期望。逐块相乘:

\[ \begin{aligned} \Sigma_{\mathrm{joint}} &:=\operatorname{Cov} \begin{bmatrix}\bar X\\\bar Y\end{bmatrix}\\ &=\mathbb E\!\left[ \begin{bmatrix}\bar X\\\bar Y\end{bmatrix} \begin{bmatrix}\bar X^\top&\bar Y^\top\end{bmatrix} \right]\\ &= \begin{bmatrix} \mathbb E[\bar X\bar X^\top]&\mathbb E[\bar X\bar Y^\top]\\ \mathbb E[\bar Y\bar X^\top]&\mathbb E[\bar Y\bar Y^\top] \end{bmatrix}\\ &= \begin{bmatrix} \Sigma_1&C\\ C^\top&\Sigma_2 \end{bmatrix}. \end{aligned} \]

左下角是 \(C^\top\),因为

\[ \mathbb E[\bar Y\bar X^\top] =\mathbb E[(\bar X\bar Y^\top)^\top] =(\mathbb E[\bar X\bar Y^\top])^\top =C^\top. \]

因此

\[ \boxed{ \Sigma_{\mathrm{joint}} = \begin{bmatrix} \Sigma_1&C\\ C^\top&\Sigma_2 \end{bmatrix} }. \tag{4.4} \]

这里 \(\Sigma_{\mathrm{joint}}\) 表示联合协方差;\(\Gamma\) 仍只表示第 2 节的离散运输矩阵。

** 第二步:证明“存在耦合产生 \(C\)”等价于联合协方差半正定 **

先把要证明的充要命题完整写出来。本节始终固定两个 Gaussian 边缘分布 \(P=\mathcal N(\mu_1,\Sigma_1)\)、\(Q=\mathcal N(\mu_2,\Sigma_2)\),再给定一个确定性的候选矩阵 \(C\in\mathbb R^{d\times d}\):

  • 左边命题:存在一个合法耦合 \(\gamma\in\Pi(P,Q)\),使它产生的交叉协方差 \(C_\gamma=\mathbb E_\gamma[\bar X\bar Y^\top]\) 恰好等于候选矩阵 \(C\);
  • 右边命题:把 \(C\) 放进式 (4.4) 后,得到的联合协方差矩阵满足 \(\Sigma_{\mathrm{joint}}\succeq0\)。

要证明的是

\[ \boxed{ \left[ \exists\,\gamma\in\Pi(P,Q) \text{ 使 }C=C_\gamma \right] \iff \left[ \Sigma_{\mathrm{joint}}\succeq0 \right] }. \]

其中 \(C\) 始终是确定性矩阵,不是随机变量或随机事件。方括号中的完整陈述才是可以判断真假的命题。 这里 \(C\) 是我们先写下来的“候选答案”,\(C_\gamma\) 是某个实际耦合 \(\gamma\) 计算出来的结果; 等式 \(C=C_\gamma\) 问的就是:能否找到一种配对规律,使实际结果恰好等于这个候选答案。

“右边是左边的必要条件”是说:若左边成立,右边必然成立,即

\[ \text{存在耦合产生 }C \quad\Longrightarrow\quad \Sigma_{\mathrm{joint}}\succeq0. \]

“右边是左边的充分条件”是说:只要右边成立,就能构造出左边所说的耦合,即

\[ \Sigma_{\mathrm{joint}}\succeq0 \quad\Longrightarrow\quad \text{存在耦合产生 }C. \]

两个方向都证明后,才能使用双向箭头 \(\iff\)。

这里必须保留“两个边缘分布是 Gaussian”这个前提。下面的必要性对任何具有有限二阶矩的分布都成立, 但充分性要用联合 Gaussian 作构造;对于任意指定的非 Gaussian 边缘分布,联合协方差半正定未必足以保证 存在具有这些边缘分布的耦合。

** 必要性:存在耦合产生 \(C\) \(\Longrightarrow\) 联合协方差半正定 **

假设左边命题成立,也就是确实存在一个耦合 \(\gamma\),使 \(C=C_\gamma\)。在这个耦合下,式 (4.4) 确实是联合随机向量的协方差:

\[ \Sigma_{\mathrm{joint}} =\mathbb E_\gamma\!\left[ \begin{bmatrix}\bar X\\\bar Y\end{bmatrix} \begin{bmatrix}\bar X\\\bar Y\end{bmatrix}^{\!\top} \right]. \]

先看清证明路线,再进入计算:

  1. 任意选择两个方向 \(a,b\);它们只是用来检验矩阵的任意测试向量,不是需要求解的未知量;
  2. 用这两个方向组成一个实随机变量 \(S=a^\top\bar X+b^\top\bar Y\);
  3. \(S\) 的均值为 0,所以 \(\operatorname{Var}(S)=\mathbb E[S^2]\ge0\);
  4. 下面将直接算出,\(\operatorname{Var}(S)\) 正好等于联合协方差的二次型 \(t^\top\Sigma_{\mathrm{joint}}t\);
  5. 因为任意测试向量都得到非负二次型,所以联合协方差半正定。

按照半正定的定义,一个对称矩阵 \(M\) 满足 \(M\succeq0\),是指对每一个同维确定性向量 \(t\) 都有

\[ t^\top Mt\ge0. \]

\(\Sigma_{\mathrm{joint}}\) 是 \(2d\times2d\) 矩阵,所以要使用任意 \(2d\) 维确定性向量。每个这样的向量都可以上下拆成两个 \(d\) 维向量:

\[ t= \begin{bmatrix}a\\b\end{bmatrix}, \qquad a,b\in\mathbb R^d. \]

这里的 \(a,b\) 没有特定数值:“任意 \(t\)”与“任意 \(a,b\)”表达的是同一件事。它们分别指定从 \(\bar X\) 和 \(\bar Y\) 中取哪一个线性方向。

现在从联合协方差定义逐步计算二次型:

\[ \begin{aligned} t^\top\Sigma_{\mathrm{joint}}t &=t^\top \mathbb E_\gamma\!\left[ \begin{bmatrix}\bar X\\\bar Y\end{bmatrix} \begin{bmatrix}\bar X\\\bar Y\end{bmatrix}^{\!\top} \right]t\\ &=\mathbb E_\gamma\!\left[ t^\top \begin{bmatrix}\bar X\\\bar Y\end{bmatrix} \begin{bmatrix}\bar X\\\bar Y\end{bmatrix}^{\!\top} t \right]\\ &=\mathbb E_\gamma\!\left[ \left( t^\top\begin{bmatrix}\bar X\\\bar Y\end{bmatrix} \right) \left( \begin{bmatrix}\bar X\\\bar Y\end{bmatrix}^{\!\top}t \right) \right]\\ &=\mathbb E_\gamma\!\left[ \left( t^\top\begin{bmatrix}\bar X\\\bar Y\end{bmatrix} \right)^2 \right]\\ &=\mathbb E_\gamma[(a^\top\bar X+b^\top\bar Y)^2]\\ &=\mathbb E_\gamma[S^2]\\ &=\operatorname{Var}_\gamma(S)\\ &\ge0. \end{aligned} \]

第二个等号能把确定性向量 \(t\) 移进期望,是因为期望对加法和确定性系数是线性的。第三、第四个等号使用了“一个实数的转置仍是它本身”。又因为\(\mathbb E_\gamma[S]=a^\top\mathbb E_\gamma[\bar X]+b^\top\mathbb E_\gamma[\bar Y]=0\),所以\(\mathbb E_\gamma[S^2]=\operatorname{Var}_\gamma(S)\);任何实随机变量的方差都不可能为负。

由于这个结论对任意 \(t\in\mathbb R^{2d}\) 都成立,按照半正定定义便得到

\[ \Sigma_{\mathrm{joint}}\succeq0. \]

直观地说,如果该矩阵不是半正定,就会存在某个 \(t\),使\(\mathbb E_\gamma[(a^\top\bar X+b^\top\bar Y)^2]<0\);这相当于“某个实随机变量的平方平均值为负”,不可能由真实随机变量产生。因此半正定是存在真实耦合的必要条件。

** 充分性:联合协方差半正定 \(\Longrightarrow\) 构造出产生 \(C\) 的耦合 **

现在假设右边命题成立,即式 (4.4) 中的 \(\Sigma_{\mathrm{joint}}\succeq0\)。半正定矩阵存在唯一的半正定主平方根 \(\Sigma_{\mathrm{joint}}^{1/2}\)。取一个 \(2d\) 维标准 Gaussian 随机向量

\[ G\sim\mathcal N(0,I_{2d}), \]

并定义联合随机向量

\[ \begin{bmatrix}\bar X\\\bar Y\end{bmatrix} :=\Sigma_{\mathrm{joint}}^{1/2}G. \]

这是标准 Gaussian 的线性变换,所以仍为联合 Gaussian。它的均值为

\[ \mathbb E \begin{bmatrix}\bar X\\\bar Y\end{bmatrix} =\Sigma_{\mathrm{joint}}^{1/2}\mathbb E[G] =0, \]

协方差为

\[ \begin{aligned} \operatorname{Cov} \begin{bmatrix}\bar X\\\bar Y\end{bmatrix} &=\Sigma_{\mathrm{joint}}^{1/2} \operatorname{Cov}(G) \left(\Sigma_{\mathrm{joint}}^{1/2}\right)^\top\\ &=\Sigma_{\mathrm{joint}}^{1/2}I_{2d} \Sigma_{\mathrm{joint}}^{1/2}\\ &=\Sigma_{\mathrm{joint}}. \end{aligned} \]

对照式 (4.4) 的四个块:左上块说明 \(\bar X\sim\mathcal N(0,\Sigma_1)\),右下块说明\(\bar Y\sim\mathcal N(0,\Sigma_2)\),右上块说明

\[ \mathbb E[\bar X\bar Y^\top]=C. \]

最后把均值加回去:

\[ X:=\mu_1+\bar X, \qquad Y:=\mu_2+\bar Y. \]

于是 \(X\sim P=\mathcal N(\mu_1,\Sigma_1)\)、\(Y\sim Q=\mathcal N(\mu_2,\Sigma_2)\)。令 \(\gamma\) 为这对 \((X,Y)\) 的联合分布,便得到一个合法耦合 \(\gamma\in\Pi(P,Q)\),而且 \(C_\gamma=C\)。因此左边命题成立,充分性得证。

两个方向合起来,完成了开头所写的充要命题。

** 第三步:用 Schur 补把分块约束改写成只含 \(C\) 的约束 **

联合协方差是 \(2d\times2d\) 的大矩阵,不方便直接放进 4.4 节优化。现在假设 \(\Sigma_1,\Sigma_2\succ0\),从而 \(\Sigma_2^{-1}\) 存在;目标是把 \(\Sigma_{\mathrm{joint}}\succeq0\) 改写成一个只含 \(\Sigma_1,\Sigma_2,C\) 的 \(d\times d\) 条件。

对任意确定性向量 \(a,b\in\mathbb R^d\),将分块二次型直接展开:

\[ \begin{bmatrix}a\\b\end{bmatrix}^{\!\top} \Sigma_{\mathrm{joint}} \begin{bmatrix}a\\b\end{bmatrix} =a^\top\Sigma_1a+2a^\top Cb+b^\top\Sigma_2b. \]

判断 \(\Sigma_{\mathrm{joint}}\) 是否半正定,就是判断这个二次型对每个 \(a,b\) 是否都非负。固定 \(a\) 后,右边是关于 \(b\) 的二次函数。对 \(b\) 配方:

\[ \begin{aligned} \begin{bmatrix}a\\b\end{bmatrix}^{\!\top} \Sigma_{\mathrm{joint}} \begin{bmatrix}a\\b\end{bmatrix} ={}&\left(b+\Sigma_2^{-1}C^\top a\right)^\top \Sigma_2 \left(b+\Sigma_2^{-1}C^\top a\right)\\ &+a^\top\left(\Sigma_1-C\Sigma_2^{-1}C^\top\right)a. \end{aligned} \]

为什么要这样配方?因为 \(\Sigma_2\succ0\),第一项必定非负,并且在

\[ b_*=-\Sigma_2^{-1}C^\top a \]

处恰好等于 0。因此固定 \(a\) 时,上述二次型对所有 \(b\) 的最小值就是

\[ \min_b \begin{bmatrix}a\\b\end{bmatrix}^{\!\top} \Sigma_{\mathrm{joint}} \begin{bmatrix}a\\b\end{bmatrix} =a^\top\left(\Sigma_1-C\Sigma_2^{-1}C^\top\right)a. \]

所以“对所有 \(a,b\),上述分块二次型都非负”等价于“对所有 \(a\),上面的最小值都非负”。按照半正定定义,

\[ \boxed{ \Sigma_{\mathrm{joint}}\succeq0 \iff \Sigma_1-C\Sigma_2^{-1}C^\top\succeq0 }. \tag{4.5} \]

右边的矩阵称为相对于 \(\Sigma_2\) 的 Schur 补。这个名称不影响使用;关键含义是:它精确描述了在 \(\Sigma_1,\Sigma_2\) 固定时,\(C\) 不能大到什么程度。

** 第四步:去掉两边的尺度,把约束化成“相关系数不超过 1” **

式 (4.5) 仍同时混有三个协方差矩阵。仿照一维相关系数 \(k=c/(\sigma_1\sigma_2)\),定义去尺度后的矩阵

\[ K:=\Sigma_1^{-1/2}C\Sigma_2^{-1/2}. \]

等价地,把两边尺度乘回去:

\[ C=\Sigma_1^{1/2}K\Sigma_2^{1/2}. \tag{4.6} \]

这就是本节开头预告的形式。把式 (4.6) 代入 Schur 补,其中

\[ \begin{aligned} C\Sigma_2^{-1}C^\top ={}&\Sigma_1^{1/2}K\Sigma_2^{1/2} \Sigma_2^{-1} \Sigma_2^{1/2}K^\top\Sigma_1^{1/2}\\ ={}&\Sigma_1^{1/2}KK^\top\Sigma_1^{1/2}. \end{aligned} \]

第二行使用了 \(\Sigma_2^{1/2}\Sigma_2^{-1}\Sigma_2^{1/2}=I\)。因此

\[ \Sigma_1-C\Sigma_2^{-1}C^\top =\Sigma_1^{1/2}(I-KK^\top)\Sigma_1^{1/2}. \]

由于 \(\Sigma_1^{1/2}\) 可逆,左右乘它的合同变换不会改变半正定性,于是式 (4.5) 等价于

\[ \boxed{ I-KK^\top\succeq0 }. \tag{4.7} \]

这个条件的含义可以直接从二次型读出。对任意确定性向量 \(a\),

\[ \begin{aligned} a^\top(I-KK^\top)a &=a^\top a-a^\top KK^\top a\\ &=\|a\|_2^2-\|K^\top a\|_2^2\\ &\ge0. \end{aligned} \]

所以 \(\|K^\top a\|_2\le\|a\|_2\):\(K^\top\) 不会放大任何向量。矩阵的最大长度放大倍数等于最大 奇异值,而 \(K,K^\top\) 具有相同奇异值,因此 \(K\) 的每个奇异值都不超过 1。这样的 \(K\) 称为 压缩矩阵。

本节输出:4.4 节真正要用的可行域

在 \(\Sigma_1,\Sigma_2\succ0\) 的假设下,把以上等价关系串起来:

\[ \boxed{ \begin{aligned} C\text{ 能由某个合法耦合产生} \iff{}& C=\Sigma_1^{1/2}K\Sigma_2^{1/2},\\ &K\text{ 的所有奇异值都不超过 }1. \end{aligned} } \]

因此 4.3 节并没有在求最优 \(C\);它只是把“合法耦合”翻译成一个可以优化的矩阵约束。4.4 节才会在这些压缩矩阵 \(K\) 中选择使 \(\operatorname{Tr}(C)\) 最大的那个。

4.4 第四步:在约束下最大化 \(\operatorname{Tr}(C)\)

先解释本节会反复用到的迹的循环性质。若 \(A\in\mathbb R^{m\times n}\)、\(B\in\mathbb R^{n\times m}\),那么根据矩阵乘法和迹的元素定义,

\[ \begin{aligned} \operatorname{Tr}(AB) &=\sum_{i=1}^{m}(AB)_{ii}\\ &=\sum_{i=1}^{m}\sum_{j=1}^{n}A_{ij}B_{ji}\\ &=\sum_{j=1}^{n}\sum_{i=1}^{m}B_{ji}A_{ij}\\ &=\sum_{j=1}^{n}(BA)_{jj}\\ &=\operatorname{Tr}(BA). \end{aligned} \]

第三个等号只是交换有限求和的先后次序;矩阵元素都是实数,所以 \(A_{ij}B_{ji}=B_{ji}A_{ij}\)。 由这个二矩阵公式可得多个矩阵的循环性质。

现在把式 (4.6) 的 \(C=\Sigma_1^{1/2}K\Sigma_2^{1/2}\) 代入,并把最前面的 \(\Sigma_1^{1/2}\) 循环移动到末尾:

\[ \begin{aligned} \operatorname{Tr}(C) &=\operatorname{Tr}\!\left(\Sigma_1^{1/2}K\Sigma_2^{1/2}\right)\\ &=\operatorname{Tr}\!\left(K\Sigma_2^{1/2}\Sigma_1^{1/2}\right). \end{aligned} \tag{4.8} \]

记

\[ M=\Sigma_2^{1/2}\Sigma_1^{1/2}. \]

对 \(M\) 作奇异值分解:

\[ M=U\operatorname{diag}(s_1,\ldots,s_d)V^\top, \qquad s_i\ge0. \]

令 \(H=V^\top K U\)。正交矩阵 \(U,V\) 不改变奇异值,所以 \(H\) 也是压缩矩阵。令 \(e_i\) 为第 \(i\) 个标准基向量,由 Cauchy--Schwarz 不等式,

\[ |H_{ii}|=|e_i^\top H e_i| \le\|e_i\|_2\|He_i\|_2\le1. \]

于是可以继续计算。先把 \(M=U\operatorname{diag}(s_1,\ldots,s_d)V^\top\) 原样代入:

\[ \begin{aligned} \operatorname{Tr}(KM) &=\operatorname{Tr}\!\left( K U\operatorname{diag}(s_1,\ldots,s_d)V^\top \right)\\ &=\operatorname{Tr}\!\left( V^\top K U\operatorname{diag}(s_1,\ldots,s_d) \right)\\ &=\operatorname{Tr}\!\left( H\operatorname{diag}(s_1,\ldots,s_d) \right)\\ &=\sum_{i=1}^d s_iH_{ii}\\ &\le\sum_{i=1}^d s_i. \end{aligned} \tag{4.9} \]

第一个到第二个等号只是把最后的 \(V^\top\) 循环移动到最前面:

\[ \operatorname{Tr}\!\left(KU\operatorname{diag}(s_i)V^\top\right) =\operatorname{Tr}\!\left(V^\top KU\operatorname{diag}(s_i)\right), \]

并没有交换任意两个矩阵。第二个到第三个等号代入了定义 \(H=V^\top KU\)。最后,由于 \(\operatorname{diag}(s_1,\ldots,s_d)\) 只有对角线元素非零,乘积的第 \(i\) 个对角线元素为 \(H_{ii}s_i\),所以它的迹是 \(\sum_{i=1}^d H_{ii}s_i\)。

取

\[ K_*=VU^\top \]

时,\(K_*K_*^\top=I\),所以它满足式 (4.7);同时 \(H=V^\top K_*U=I\),式 (4.9) 取等号。也就是说,最大可能的交叉迹就是 \(M\) 的奇异值之和。

另一方面,\(M\) 的奇异值平方是 \(M^\top M\) 的特征值,而

\[ M^\top M =\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}. \]

因此

\[ \max_C\operatorname{Tr}(C) =\sum_i s_i =\operatorname{Tr}\!\left[ \left(\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}\right)^{1/2} \right]. \tag{4.10} \]

4.5 第五步:代回运输成本

将式 (4.10) 代入式 (4.3),再与均值项式 (4.2) 合并:

\[ \begin{aligned} W_2^2(P,Q) ={}&\|\mu_1-\mu_2\|_2^2 +\operatorname{Tr}(\Sigma_1) +\operatorname{Tr}(\Sigma_2)\\ &-2\operatorname{Tr}\!\left[ \left(\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}\right)^{1/2} \right], \end{aligned} \]

这正是式 (4.1)。

这个最优值不是只能无限接近却无法达到的下界。4.4 节选出的 \(K_*=VU^\top\) 满足\(K_*K_*^\top=I\),因而满足式 (4.7)。由 4.3 节已经证明的等价关系,它对应的

\[ C_*=\Sigma_1^{1/2}K_*\Sigma_2^{1/2} \]

使联合协方差 \(\Sigma_{\mathrm{joint},*}\succeq0\);而 4.3 节的充分性构造又保证存在一个以 \(\mathcal N(0,\Sigma_1)\)、\(\mathcal N(0,\Sigma_2)\) 为边缘的联合 Gaussian,其交叉协方差正是 \(C_*\)。因此确实有一个合法耦合达到式 (4.10),前面的 \(\inf\) 在此取到。

若协方差只是半正定而不可逆,可先把它们换成 \(\Sigma_i+\varepsilon I\),对每个 \(\varepsilon>0\) 使用上述证明,再令 \(\varepsilon\downarrow0\)。矩阵平方根和 \(W_2\) 对这个极限连续,所以式 (4.1) 也适用于退化 Gaussian;EWD 的单条边正是这种秩为 1 的情形。

4.6 等价的最优仿射传输映射

当 \(\Sigma_1\succ0\) 时,还可以显式写出从第一个 Gaussian 到第二个 Gaussian 的最优映射9:

\[ T(x)=\mu_2+A(x-\mu_1), \]

其中

\[ A=\Sigma_1^{-1/2} \left(\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}\right)^{1/2} \Sigma_1^{-1/2}. \tag{4.11} \]

先验证它确实把协方差 \(\Sigma_1\) 变成 \(\Sigma_2\):

\[ \begin{aligned} A\Sigma_1A^\top ={}&\Sigma_1^{-1/2}G\Sigma_1^{-1/2} \Sigma_1 \Sigma_1^{-1/2}G\Sigma_1^{-1/2}\\ ={}&\Sigma_1^{-1/2}G^2\Sigma_1^{-1/2}\\ ={}&\Sigma_1^{-1/2} (\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}) \Sigma_1^{-1/2}\\ ={}&\Sigma_2, \end{aligned} \]

其中 \(G=(\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2})^{1/2}\)。现在把此前省略的代价计算展开。令 \(\bar X=X-\mu_1\),则

\[ X-T(X)=(\mu_1-\mu_2)+(I-A)\bar X. \]

由于 \(\mathbb E[\bar X]=0\),均值项与中心化项的交叉期望为 0,因此

\[ \begin{aligned} \mathbb E\|X-T(X)\|_2^2 ={}&\|\mu_1-\mu_2\|_2^2\\ &+\operatorname{Tr}\!\left[(I-A)\Sigma_1(I-A)^\top\right]. \end{aligned} \]

\(A\) 对称,且已经证明 \(A\Sigma_1A^\top=\Sigma_2\)。把迹项逐项展开:

\[ \begin{aligned} &\operatorname{Tr}\!\left[(I-A)\Sigma_1(I-A)^\top\right]\\ &=\operatorname{Tr}(\Sigma_1) -\operatorname{Tr}(A\Sigma_1) -\operatorname{Tr}(\Sigma_1A^\top) +\operatorname{Tr}(A\Sigma_1A^\top)\\ &=\operatorname{Tr}(\Sigma_1)+\operatorname{Tr}(\Sigma_2) -2\operatorname{Tr}(A\Sigma_1). \end{aligned} \]

最后利用迹的循环性质,

\[ \begin{aligned} \operatorname{Tr}(A\Sigma_1) &=\operatorname{Tr} \left(\Sigma_1^{-1/2}G\Sigma_1^{-1/2}\Sigma_1\right)\\ &=\operatorname{Tr} \left(\Sigma_1^{1/2}\Sigma_1^{-1/2}G\right) =\operatorname{Tr}(G). \end{aligned} \]

代回后恰好得到式 (4.1)。由于第 4.4 节已经证明任何耦合的代价都不可能更低,这个仿射映射不仅 把两个分布对应起来,而且确实最优。式 (4.11) 提供直觉:最优运输同时完成中心平移和椭圆形状的最省二次代价变换。

五、从一般闭式继续化简到检测可用公式

5.1 协方差可交换时

如果

\[ \Sigma_1\Sigma_2=\Sigma_2\Sigma_1, \]

两个对称矩阵可以用同一组正交特征向量对角化。此时

\[ \left(\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}\right)^{1/2} =\Sigma_1^{1/2}\Sigma_2^{1/2}. \]

协方差部分变成

\[ \begin{aligned} &\operatorname{Tr}(\Sigma_1+\Sigma_2 -2\Sigma_1^{1/2}\Sigma_2^{1/2})\\ &=\operatorname{Tr}\!\left[ (\Sigma_1^{1/2}-\Sigma_2^{1/2})^2 \right]\\ &=\|\Sigma_1^{1/2}-\Sigma_2^{1/2}\|_F^2. \end{aligned} \tag{5.1} \]

所以

\[ W_2^2(P,Q) =\|\mu_1-\mu_2\|_2^2 +\|\Sigma_1^{1/2}-\Sigma_2^{1/2}\|_F^2. \tag{5.2} \]

不能对任意两个旋转框直接使用式 (5.2)。 两个不同朝向、非圆形的椭圆协方差通常不交换。 NWD 的水平框协方差都是对角矩阵,所以它们一定交换;GWD 必须使用一般式或二维专用闭式。

5.2 水平框:退化成一个四维欧氏距离

对两个水平框

\[ B_i=(c_{xi},c_{yi},w_i,h_i), \]

有

\[ \mu_i=\begin{bmatrix}c_{xi}\\c_{yi}\end{bmatrix}, \qquad \Sigma_i^{1/2}=\begin{bmatrix}w_i/2&0\\0&h_i/2\end{bmatrix}. \]

代入式 (5.2):

\[ \boxed{ W_2^2(B_1,B_2) =(c_{x1}-c_{x2})^2 +(c_{y1}-c_{y2})^2 +\frac{(w_1-w_2)^2}{4} +\frac{(h_1-h_2)^2}{4}. } \tag{5.3} \]

定义四维嵌入

\[ z(B)=\begin{bmatrix}c_x&c_y&w/2&h/2\end{bmatrix}^\top, \]

则

\[ W_2^2(B_1,B_2)=\|z(B_1)-z(B_2)\|_2^2. \tag{5.4} \]

这不是近似式,而是在论文选定的 Gaussian 编码下的精确闭式。GWD 论文把最后一行写成 “\(l_2\)-norm”,但严格说右边是 \(l_2\) 范数的平方。

5.3 任意二维协方差:不用显式求矩阵平方根

对任意 \(2\times2\) 半正定矩阵 \(Z\),设特征值为 \(\lambda_1,\lambda_2\ge0\),则

\[ \operatorname{Tr}(Z^{1/2})=\sqrt{\lambda_1}+\sqrt{\lambda_2}. \]

两边平方:

\[ \begin{aligned} [\operatorname{Tr}(Z^{1/2})]^2 &=\lambda_1+\lambda_2+2\sqrt{\lambda_1\lambda_2}\\ &=\operatorname{Tr}(Z)+2\sqrt{\det Z}. \end{aligned} \]

所以

\[ \operatorname{Tr}(Z^{1/2}) =\sqrt{\operatorname{Tr}(Z)+2\sqrt{\det Z}}. \tag{5.5} \]

令

\[ Z=\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}, \]

利用迹的循环性质和行列式的乘法性质:

\[ \operatorname{Tr}(Z)=\operatorname{Tr}(\Sigma_1\Sigma_2), \qquad \det Z=\det\Sigma_1\det\Sigma_2. \]

因此二维 Gaussian 的闭式也可写成

\[ \boxed{ \begin{aligned} W_2^2(P,Q) ={}&\|\mu_1-\mu_2\|_2^2 +\operatorname{Tr}(\Sigma_1)+\operatorname{Tr}(\Sigma_2)\\ &-2\sqrt{ \operatorname{Tr}(\Sigma_1\Sigma_2) +2\sqrt{\det\Sigma_1\det\Sigma_2} }. \end{aligned}} \tag{5.6} \]

MMRotate 的 GWD 实现采用的就是式 (5.6),并对行列式和根号内部做数值截断10。

5.4 旋转框的显式标量公式

本节比较两个旋转框。先把它们完整写成

\[ B_1=(c_{x1},c_{y1},w_1,h_1,\theta_1), \qquad B_2=(c_{x2},c_{y2},w_2,h_2,\theta_2). \]

这里下标 \(1\) 表示第一个框,下标 \(2\) 表示第二个框。为了不把同样的定义写两遍,下面偶尔使用 \(i\in\{1,2\}\):当 \(i=1\) 时指第一个框,当 \(i=2\) 时指第二个框;\(i\) 只是编号,不是一个等待求解的 未知量,也不表示这里正在求和。

对第 \(i\) 个框,把完整宽、高的一半记成

\[ a_i=w_i/2, \qquad b_i=h_i/2, \]

所以具体来说,\(a_1=w_1/2,b_1=h_1/2\),而 \(a_2=w_2/2,b_2=h_2/2\)。在本章采用的 Gaussian 编码中,它的协方差为

\[ \Sigma_i =R_{\theta_i} \begin{bmatrix}a_i^2&0\\0&b_i^2\end{bmatrix} R_{\theta_i}^\top. \]

\(\theta_1,\theta_2\) 都是相对于同一条全局 \(x\) 轴测量的框朝向,单位为弧度。距离并不关心两个框相对于全局坐标系共同转了多少,只关心它们彼此错开了多少。因此定义相对角度,也就是第二个框相对于第一个框的角度差:

\[ \boxed{\phi:=\theta_2-\theta_1}. \]

下面逐步说明为什么只剩这个角度差。将整个坐标系旋转 \(-\theta_1\),等价于同时对两个协方差作

\[ \Sigma_i' :=R_{-\theta_1}\Sigma_iR_{-\theta_1}^\top. \]

同一个正交旋转不会改变式 (5.6) 中的各项,因此可以在这个新坐标系中计算。具体地,令 \(Q:=R_{-\theta_1}\),则 \(Q^\top Q=I\)。中心差经过旋转后满足

\[ \|Q(\mu_1-\mu_2)\|_2^2 =(\mu_1-\mu_2)^\top Q^\top Q(\mu_1-\mu_2) =\|\mu_1-\mu_2\|_2^2. \]

单个协方差的迹满足

\[ \operatorname{Tr}(Q\Sigma_iQ^\top) =\operatorname{Tr}(Q^\top Q\Sigma_i) =\operatorname{Tr}(\Sigma_i), \]

两个协方差的乘积迹满足

\[ \begin{aligned} \operatorname{Tr}(\Sigma_1'\Sigma_2') &=\operatorname{Tr}(Q\Sigma_1Q^\top Q\Sigma_2Q^\top)\\ &=\operatorname{Tr}(Q\Sigma_1\Sigma_2Q^\top)\\ &=\operatorname{Tr}(Q^\top Q\Sigma_1\Sigma_2)\\ &=\operatorname{Tr}(\Sigma_1\Sigma_2). \end{aligned} \]

行列式也不变,因为

\[ \det(Q\Sigma_iQ^\top) =\det(Q)\det(\Sigma_i)\det(Q^\top) =\det(\Sigma_i), \]

这里使用了旋转矩阵的 \(\det(Q)=1\)。所以式 (5.6) 的整个数值都不变。接下来利用

\[ R_\alpha R_\beta=R_{\alpha+\beta}, \qquad R_\alpha^\top=R_{-\alpha}, \]

第一个框的协方差变为

\[ \begin{aligned} \Sigma_1' &=R_{-\theta_1}R_{\theta_1} \begin{bmatrix}a_1^2&0\\0&b_1^2\end{bmatrix} R_{\theta_1}^\top R_{-\theta_1}^\top\\ &=R_0 \begin{bmatrix}a_1^2&0\\0&b_1^2\end{bmatrix} R_0^\top\\ &=\begin{bmatrix}a_1^2&0\\0&b_1^2\end{bmatrix}. \end{aligned} \]

第二个框的协方差变为

\[ \begin{aligned} \Sigma_2' &=R_{-\theta_1}R_{\theta_2} \begin{bmatrix}a_2^2&0\\0&b_2^2\end{bmatrix} R_{\theta_2}^\top R_{-\theta_1}^\top\\ &=R_{\theta_2-\theta_1} \begin{bmatrix}a_2^2&0\\0&b_2^2\end{bmatrix} R_{\theta_2-\theta_1}^\top\\ &=R_\phi \begin{bmatrix}a_2^2&0\\0&b_2^2\end{bmatrix} R_\phi^\top. \end{aligned} \]

这就是角度差 \(\phi\) 的来源:坐标系跟着第一个框转过去以后,第一个框的角度变成 \(0\),第二个框的 角度变成 \(\theta_2-\theta_1=\phi\)。为使后续公式简洁,下面省略撇号,把 \(\Sigma_1',\Sigma_2'\) 重新记作 \(\Sigma_1,\Sigma_2\)。再记 \(c:=\cos\phi,s:=\sin\phi\),此时

\[ \Sigma_1= \begin{bmatrix}a_1^2&0\\0&b_1^2\end{bmatrix}, \]

而

\[ \begin{aligned} \Sigma_2 &=R_\phi \begin{bmatrix}a_2^2&0\\0&b_2^2\end{bmatrix} R_\phi^\top\\ &= \begin{bmatrix} a_2^2c^2+b_2^2s^2&(a_2^2-b_2^2)cs\\ (a_2^2-b_2^2)cs&a_2^2s^2+b_2^2c^2 \end{bmatrix}. \end{aligned} \]

左乘对角矩阵 \(\Sigma_1\) 后,只需取两个对角元素之和:

\[ \begin{aligned} \operatorname{Tr}(\Sigma_1\Sigma_2) ={}&a_1^2(a_2^2c^2+b_2^2s^2)\\ &+b_1^2(a_2^2s^2+b_2^2c^2). \end{aligned} \]

按 \(c^2\)、\(s^2\) 重新分组,得到

\[ \begin{aligned} \operatorname{Tr}(\Sigma_1\Sigma_2) ={}&(a_1^2a_2^2+b_1^2b_2^2)\cos^2\phi\\ &+(a_1^2b_2^2+b_1^2a_2^2)\sin^2\phi, \end{aligned} \tag{5.7} \]

以及

\[ \sqrt{\det\Sigma_1\det\Sigma_2}=a_1b_1a_2b_2. \tag{5.8} \]

为了把式 (5.7)--(5.8) 合并,先使用 \(\cos^2\phi+\sin^2\phi=1\),把行列式项拆到两组:

\[ \begin{aligned} &\operatorname{Tr}(\Sigma_1\Sigma_2) +2\sqrt{\det\Sigma_1\det\Sigma_2}\\ ={}&\left(a_1^2a_2^2+b_1^2b_2^2+2a_1b_1a_2b_2\right) \cos^2\phi\\ &+\left(a_1^2b_2^2+b_1^2a_2^2+2a_1b_1a_2b_2\right) \sin^2\phi\\ ={}&(a_1a_2+b_1b_2)^2\cos^2\phi\\ &+(a_1b_2+b_1a_2)^2\sin^2\phi. \end{aligned} \]

将这个非负量定义为

\[ q^2 =(a_1a_2+b_1b_2)^2\cos^2\phi +(a_1b_2+b_1a_2)^2\sin^2\phi. \tag{5.9} \]

因此式 (5.6) 最外层的交叉平方根就是 \(\sqrt{q^2}=q\ge0\);这里写 \(\sqrt{q^2}\) 是为了提醒 读者不能在一般代数中把它无条件改成带符号的 \(q\)。

最终

\[ \boxed{ \begin{aligned} W_2^2(B_1,B_2) ={}&(c_{x1}-c_{x2})^2+(c_{y1}-c_{y2})^2\\ &+a_1^2+b_1^2+a_2^2+b_2^2-2\sqrt{q^2}. \end{aligned}} \tag{5.10} \]

式 (5.10) 只含普通标量运算,和式 (4.1)、式 (5.6) 完全等价。

5.5 四个自检情形

情形 1:两个框相同。 均值项为 0,\(q=a^2+b^2\),所以协方差项也为 0。

情形 2:角度相同。 \(\phi=0\),\(q=a_1a_2+b_1b_2\),于是

\[ W_2^2 =\|\mu_1-\mu_2\|^2+(a_1-a_2)^2+(b_1-b_2)^2, \]

与水平框式 (5.3) 一致。

情形 3:交换宽高并旋转 \(\pi/2\)。 参数

\[ (w,h,\theta) \quad\text{和}\quad (h,w,\theta+\pi/2) \]

产生同一个 \(\Sigma\),所以 GWD 为 0。参数空间中看似相差很大的两组数,在几何编码中被正确视为同一矩形。

情形 4:精确正方形。 若 \(a=b\),

\[ \Sigma=a^2I, \]

与角度无关。两个同中心、同边长的正方形无论角度差多少,Gaussian \(W_2\) 都为 0。这不是数值误差, 而是整框 Gaussian 用圆来表示正方形后必然丢失方向。EWD 论文正是从这个限制出发。

对同尺寸非正方形框,还可以量化“接近正方形时角度梯度为何变弱”。令

\[ S=a^2+b^2, \qquad D=a^2-b^2. \]

式 (5.9) 可化成

\[ q^2=S^2-D^2\sin^2\phi, \]

所以纯角度误差对应

\[ W_2^2(\phi)=2S-2\sqrt{S^2-D^2\sin^2\phi}. \tag{5.11} \]

当 \(\phi\) 很小时,\(\sin\phi\approx\phi\),再用 \(\sqrt{1-u}\approx1-u/2\):

\[ W_2^2(\phi) \approx\frac{D^2}{S}\phi^2 =\frac{(a^2-b^2)^2}{a^2+b^2}\phi^2. \tag{5.12} \]

当 \(a\to b\) 时,角度项系数按 \((a^2-b^2)^2\) 下降到 0。这给出了 near-square 角度学习停滞的定量解释。
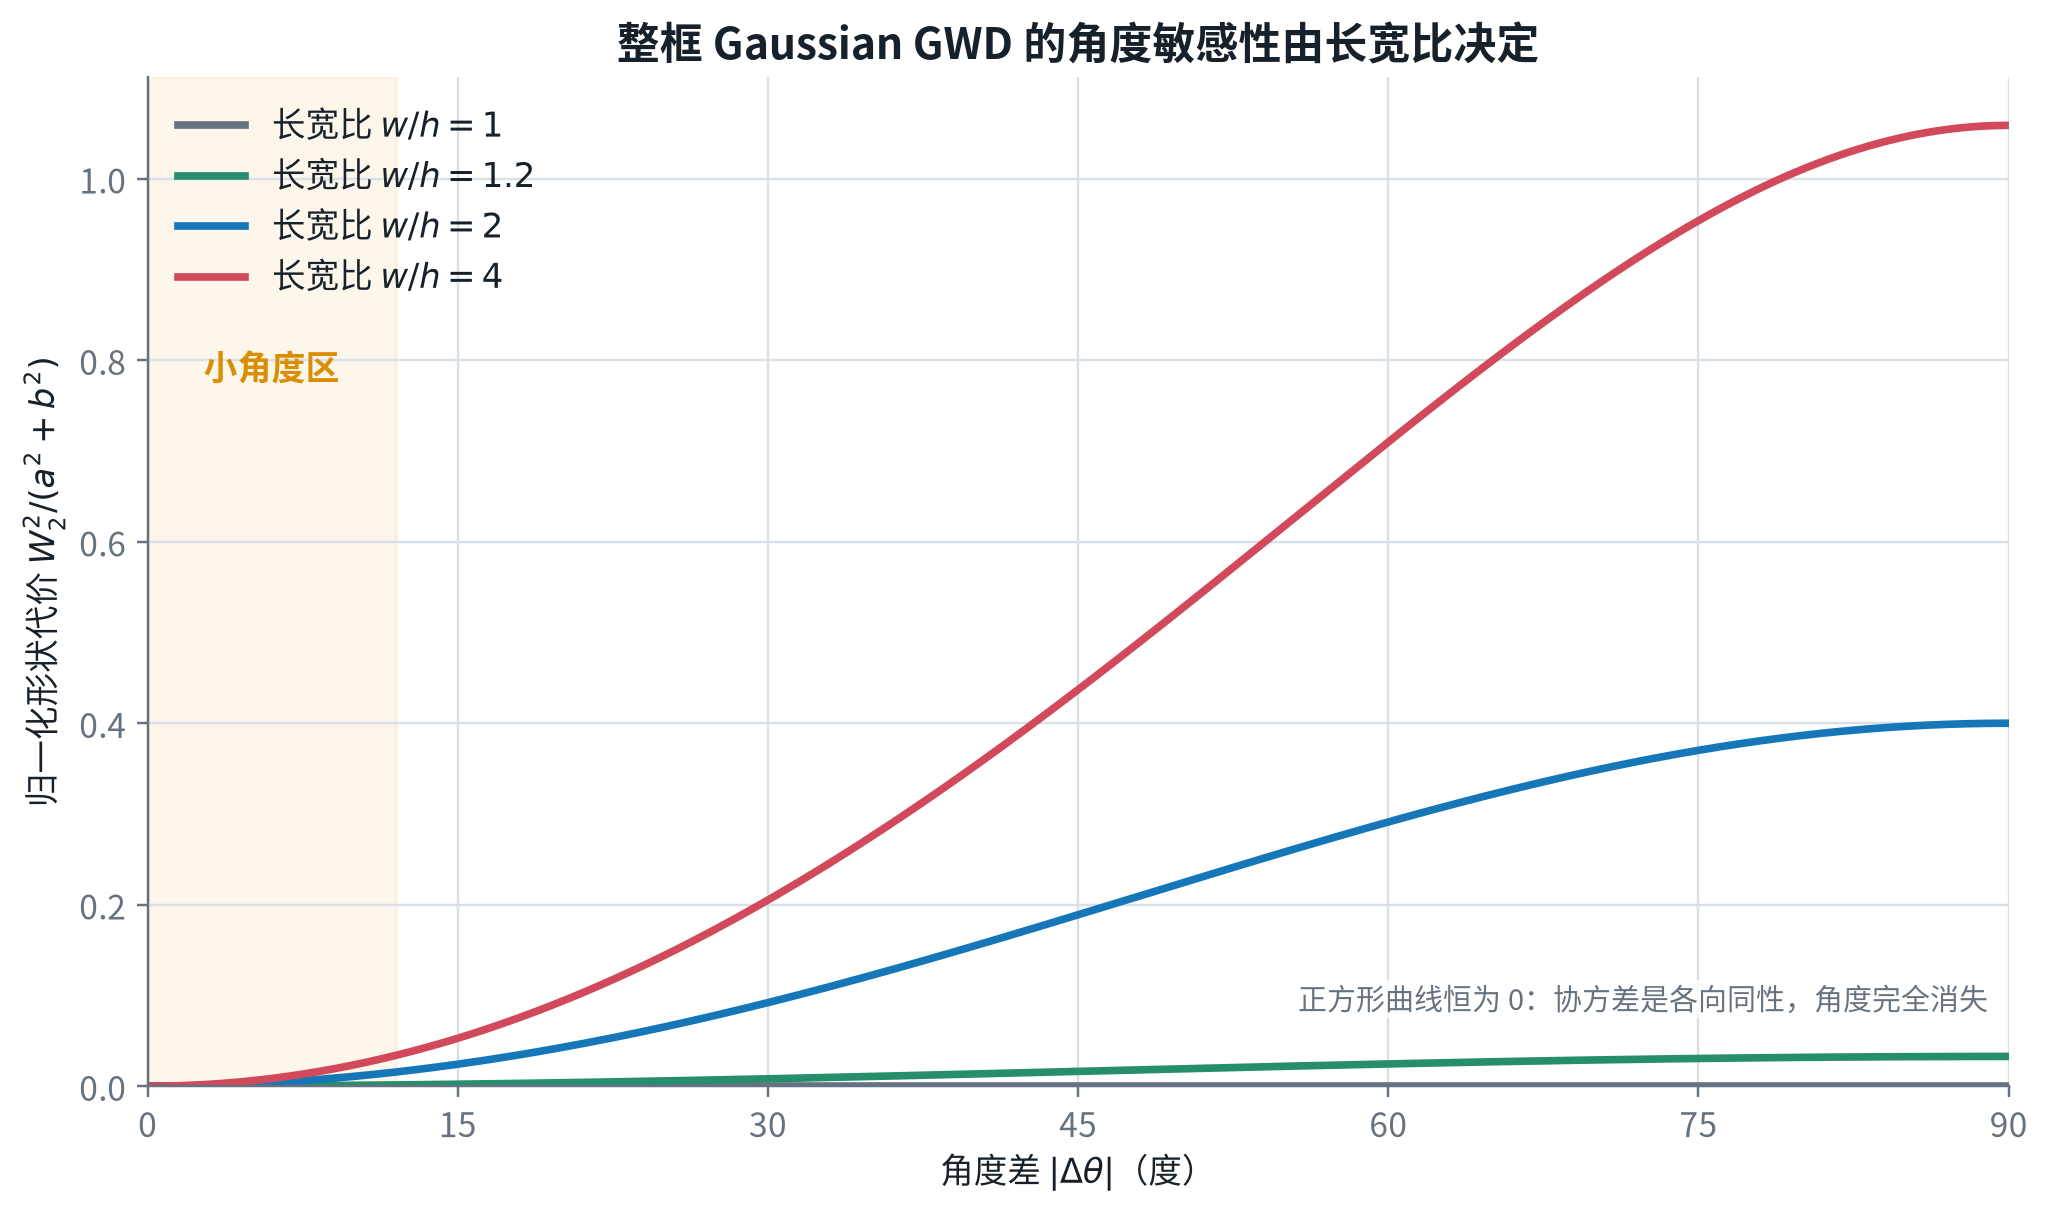
图 5-1:同中心、同尺寸框的纯角度 GWD。正方形曲线恒为 0;框越细长,GWD 对角度越敏感。曲线由式 (5.11) 生成。

六、常规水平目标检测:NWD 怎样计算 loss

6.1 从预测框和真值框得到 \(W_2\)

设一个正样本的解码预测框和真值框分别为

\[ B_p=(c_{xp},c_{yp},w_p,h_p), \qquad B_g=(c_{xg},c_{yg},w_g,h_g). \]

第一步不是直接比较网络输出的编码增量,而是把增量相对 anchor/proposal 解码回实际框坐标。 NWD 官方配置中的 reg_decoded_bbox=True 正是在保证这一点11。

第二步使用式 (5.3):

\[ \begin{aligned} d^2 &=W_2^2(B_p,B_g)\\ &=(c_{xp}-c_{xg})^2+(c_{yp}-c_{yg})^2 +\frac{(w_p-w_g)^2}{4}+\frac{(h_p-h_g)^2}{4}. \end{aligned} \tag{6.1} \]

第三步取平方根:

\[ d=W_2(B_p,B_g)=\sqrt{d^2}. \tag{6.2} \]

6.2 从距离变成 NWD 相似度

\(d\) 的单位是像素,范围是 \([0,\infty)\),不能直接代替范围在 \([0,1]\) 的 IoU。NWD 定义

\[ \boxed{ \operatorname{NWD}(B_p,B_g) =\exp\!\left(-\frac{d}{C}\right), } \tag{6.3} \]

其中 \(C>0\) 也是像素尺度。于是:

  • 两框完全相同时 \(d=0\),NWD = 1;
  • 距离增加时 NWD 单调下降;
  • 任意有限距离下 NWD 都大于 0,不会像无交集 IoU 一样突然全部变成 0。

原论文在 AI-TOD 上取 \(C=12.8\),对应数据集的平均绝对目标尺寸2。\(C\) 不是由 Wasserstein 理论自动给出的常数,而是控制相似度衰减速度的数据集超参数。

6.3 NWD 回归 loss

最终框回归项是

\[ \boxed{ \mathcal L_{\mathrm{NWD}}(B_p,B_g) =1-\operatorname{NWD}(B_p,B_g) =1-\exp\!\left(-\frac{W_2(B_p,B_g)}{C}\right). } \tag{6.4} \]

对一批样本,只有被分配为正样本的框参加回归。一个通用写法是

\[ \mathcal L_{\mathrm{box}} =\frac{1}{\max(N_+,1)} \sum_{i=1}^{N}\mathbf1_i^{+} \mathcal L_{\mathrm{NWD}}(B_{p,i},B_{g,i}), \tag{6.5} \]

再与分类、objectness 等项组合:

\[ \mathcal L_{\mathrm{total}} =\lambda_{\mathrm{cls}}\mathcal L_{\mathrm{cls}} +\lambda_{\mathrm{box}}\mathcal L_{\mathrm{box}} +\cdots. \tag{6.6} \]

NWD 官方 Faster R-CNN 配置在 RPN 使用解码框和 loss_weight=10.0;这属于多任务数值配平,不是 式 (6.4) 的数学组成部分。

6.4 一个完整数值例子

真值和预测都是 \(4\times4\) 框:

\[ B_g=(10,10,4,4), \qquad B_p=(14,10,4,4). \]

预测中心向右偏了 4 像素,两个框刚好不相交。由式 (6.1),

\[ d^2=(14-10)^2=16, \qquad d=4. \]

取 \(C=12.8\):

\[ \operatorname{NWD}=e^{-4/12.8}\approx0.731616, \]
\[ \mathcal L_{\mathrm{NWD}}\approx0.268384. \]

此时 IoU = 0,但 NWD 仍告诉优化器“只差 4 像素”。若中心偏差变成 8 像素,NWD 会继续平滑下降到 \(e^{-8/12.8}\),而不是仍停在同一个 0。

6.5 梯度从哪里来

令

\[ z= \begin{bmatrix} c_{xp}-c_{xg}\\ c_{yp}-c_{yg}\\ (w_p-w_g)/2\\ (h_p-h_g)/2 \end{bmatrix}, \qquad r=\|z\|_2. \]

则 \(\mathcal L=1-e^{-r/C}\)。当 \(r>0\) 时,链式法则给出

\[ \frac{\partial\mathcal L}{\partial z} =\frac{e^{-r/C}}{Cr}z. \tag{6.7} \]

把 \(z\) 的四个分量对原始框参数再用一次链式法则,可得逐参数梯度:

\[ \frac{\partial\mathcal L}{\partial c_{xp}} =\frac{e^{-r/C}}{Cr}(c_{xp}-c_{xg}), \qquad \frac{\partial\mathcal L}{\partial c_{yp}} =\frac{e^{-r/C}}{Cr}(c_{yp}-c_{yg}), \]
\[ \frac{\partial\mathcal L}{\partial w_p} =\frac{e^{-r/C}}{4Cr}(w_p-w_g), \qquad \frac{\partial\mathcal L}{\partial h_p} =\frac{e^{-r/C}}{4Cr}(h_p-h_g). \tag{6.8} \]

宽高梯度多出的 \(1/4\) 不是经验权重:距离平方里有 \((w_p-w_g)^2/4\),求导产生\((w_p-w_g)/2\),再经过 \(r=\sqrt{d^2}\) 产生 \(1/(2r)\),两者相乘正好是 \((w_p-w_g)/(4r)\)。

梯度方向指向当前误差向量,梯度模长为

\[ \left\|\frac{\partial\mathcal L}{\partial z}\right\|_2 =\frac{e^{-r/C}}{C}. \tag{6.9} \]

这揭示两面性:

  • 无论框是否重叠,只要 \(r>0\) 就有定位梯度;
  • 误差特别大时,指数项会使梯度衰减,\(C\) 太小会让远距离样本几乎饱和。

在 \(r=0\) 处,欧氏范数本身不可微,但这是全局最小点。若采用 Clarke 广义梯度,次微分是半径为 \(1/C\) 的闭球,因而可以选取 0;这并不把整个 NWD loss 误称为凸函数。NWD 官方实现是在中心距离中加入 eps,再计算平方根11。因此完全相同的框也会得到\(r\approx\sqrt{\varepsilon}\)、略小于 1 的相似度和略大于 0 的 loss;这属于数值稳定化,不是式(6.4) 的精确数学值。

6.6 “尺度不敏感”究竟是什么意思

NWD 论文把一个大小为 \(s\times s\) 的框平移固定的 \(k\) 个像素。若预测和真值尺寸相同,式 (6.1)只剩中心偏移 \(k\),与 \(s\) 无关。因此不同大小框在相同绝对像素误差下得到同一 NWD;这避免了微小框 IoU 对一两个像素偏差过度敏感。

但这不是严格的全局尺度不变性。若把图像中所有坐标和框尺寸同时放大 \(\alpha\) 倍,

\[ W_2(\alpha B_p,\alpha B_g)=\alpha W_2(B_p,B_g), \]

从而在固定 \(C\) 下

\[ \operatorname{NWD}(\alpha B_p,\alpha B_g) =e^{-\alpha W_2/C} \ne e^{-W_2/C}. \]

所以更准确的说法是:NWD 对框尺寸引起的 IoU 相对敏感性不敏感,但仍使用绝对像素尺度。

6.7 NWD 不只是一项 loss

原论文还把式 (6.3) 当作 IoU 的替代相似度,用在三个位置:

  1. 标签分配:按 anchor/proposal 与真值的 NWD 阈值决定正负样本;
  2. NMS:高分框与其余框 NWD 过高时,把后者视为重复框;
  3. 回归 loss:使用式 (6.4)。

论文消融中,收益最大的部分是 RPN 标签分配,而不是单独替换 loss2。这一点很重要:论文整体 AP提升不能全部归因于式 (6.4)。期刊扩展又加入了基于排序的 RKA 分配策略12。

七、旋转目标检测:GWD 怎样计算 loss

7.1 从旋转框得到 Gaussian 距离

设解码后的预测框和真值框为

\[ B_p=(x_p,y_p,w_p,h_p,\theta_p), \qquad B_g=(x_g,y_g,w_g,h_g,\theta_g). \]

计算过程是:

  1. 用式 (3.5) 得到 \((\mu_p,\Sigma_p)\) 和 \((\mu_g,\Sigma_g)\);
  2. 用式 (4.1)、式 (5.6) 或式 (5.10) 计算 \(d^2=W_2^2(\mathcal N_p,\mathcal N_g)\);
  3. 对 \(d^2\) 做非线性后处理,得到真正参加训练的 GWD loss。

第二步的二维快速式展开为

\[ \begin{aligned} d^2 ={}&\|\mu_p-\mu_g\|_2^2 +\operatorname{Tr}(\Sigma_p)+\operatorname{Tr}(\Sigma_g)\\ &-2\sqrt{ \operatorname{Tr}(\Sigma_p\Sigma_g) +2\sqrt{\det\Sigma_p\det\Sigma_g} }. \end{aligned} \tag{7.1} \]

只要先解码出旋转框,整个式子由加法、乘法、三角函数、行列式和平方根组成,可以自动微分;不需要求两个旋转多边形的交集。

7.2 原论文的最终 GWD loss

直接使用 \(d^2\) 会让大误差增长过快。论文定义一个 loss 家族:

\[ \boxed{ \mathcal L_{\mathrm{GWD}} =1-\frac{1}{\tau+f(d^2)}, \qquad \tau\ge1. } \tag{7.2} \]

在式 (7.2) 这个“倒数亲和度”家族内,论文比较了

\[ f(d^2)=\sqrt{d^2}=d \]

以及

\[ f(d^2)=\log(1+d^2). \]

主实验使用 \(f(x)=\sqrt{x}\)、\(\tau=2\)1。附录还比较了另一个不带倒数亲和度和 \(\tau\)的 家族:

\[ \widetilde{\mathcal L}_{\mathrm{GWD}}=f(d^2). \]

在这个直接后处理家族中,\(f(d^2)=\log(1+d^2)\) 的结果优于直接使用 \(\sqrt{d^2}\);它不能写回式 (7.2) 后仍声称是同一个实验变体1。因此“GWD loss”不是唯一的裸 \(W_2\) 公式,复现实验时必须同时报告:输入后处理的是 \(W_2^2\) 还是 \(W_2\)、使用哪个 \(f\)、是否使用倒数亲和度以及\(\tau\)。

这两个家族的梯度也不同。令 \(x=d^2\)。对式 (7.2),链式法则给出

\[ \frac{\mathrm d\mathcal L_{\mathrm{GWD}}}{\mathrm dx} =\frac{f'(x)}{[\tau+f(x)]^2}. \]

所以

\[ f(x)=\sqrt{x} \quad\Longrightarrow\quad \frac{\mathrm d\mathcal L}{\mathrm dx} =\frac1{2\sqrt{x}(\tau+\sqrt{x})^2}, \]

而

\[ f(x)=\log(1+x) \quad\Longrightarrow\quad \frac{\mathrm d\mathcal L}{\mathrm dx} =\frac1{(1+x)[\tau+\log(1+x)]^2}. \]

直接后处理 \(\widetilde{\mathcal L}=\log(1+x)\) 则有

\[ \frac{\mathrm d\widetilde{\mathcal L}}{\mathrm dx}=\frac1{1+x}. \]

平方根式对 \(x\) 的导数在 \(x=0\) 发散;与本身对参数近似二次的 \(x\) 复合后,局部行为类似欧氏范数,在完全匹配点通常不可微。实现中的 clamp 或 \(\varepsilon\) 决定自动微分在该点实际返回什么。

若两个同形同角框只相差 3 像素中心位移,则 \(d^2=9,d=3\)。主设置给出

\[ \mathcal L_{\mathrm{GWD}} =1-\frac{1}{2+3}=0.8. \]

当两框完全相同时,\(d^2=0\)。若 \(\tau=2\),loss 为 \(1-1/2=0.5\) 而不是 0。这个常数偏移不会改变对框参数的梯度或最优位置,但会改变日志中的 loss 基线和它与分类项的数值比例。若 \(\tau=1\),完美匹配的 loss 才为 0。

7.3 为什么不再单独回归角度差

Smooth L1 常把五个参数分别相加:

\[ \mathcal L_{\mathrm{reg}} =\ell(\Delta x)+\ell(\Delta y)+\ell(\Delta w)+\ell(\Delta h)+\ell(\Delta\theta). \]

这样 \(\Delta\theta\) 的权重不随长宽比改变,而且角度边界会跳变。GWD 先让\(w,h,\theta\) 共同构造 \(\Sigma\),再比较两个协方差。角度误差因此自动和形状耦合:由式 (5.12),细长框的角度项系数大,近方形框的系数小。

同一个协方差还天然满足

\[ \Sigma(w,h,\theta) =\Sigma(h,w,\theta+\pi/2) =\Sigma(w,h,\theta+\pi). \tag{7.3} \]

所以宽高交换和 \(\pi\) 周期不会在 loss 中制造人为跳变。

7.4 没有重叠时为什么仍有梯度

\(d^2\) 的中心项始终是

\[ (x_p-x_g)^2+(y_p-y_g)^2. \]

无论两个旋转矩形有没有交集,这一项都连续存在。协方差项也连续比较尺度和方向。因此 GWD 不会在 SkewIoU = 0 后丢失所有几何信息。

这不等于“GWD 就是可微的旋转 IoU”。它是与 IoU 变化趋势较一致的分布距离代理,式 (7.2) 还通过经验后处理拟合 IoU loss 的数值形状;二者并不逐框相等。

7.5 GWD 的多任务总 loss

原论文以 RetinaNet 为例,写成

\[ \mathcal L =\frac{\lambda_1}{N} \sum_{n=1}^{N}\operatorname{obj}_n \mathcal L_{\mathrm{GWD}}(B_{pn},B_{gn}) +\frac{\lambda_2}{N} \sum_{n=1}^{N}\mathcal L_{\mathrm{cls}}(\hat y_n,y_n). \tag{7.4} \]

\(B_{pn},B_{gn}\) 分别是第 \(n\) 个预测框与其真值框;\(\operatorname{obj}_n=1\) 表示前景,背景框不做回归;\(\hat y_n,y_n\) 分别表示分类预测与类别标签,分类项使用 focal loss。

7.6 GWD 解决的 square-like 问题和它留下的问题

需要区分两个含义:

  • 参数标签歧义:近方形框的 \(w/h\) 交换和角度跳变会让 Smooth L1 很大。GWD 把等价参数映射到 相同或接近的协方差,能缓解这种训练冲突。
  • 几何方向信息:真实正方形旋转一个非 \(\pi/2\) 角后,旋转多边形 IoU 会改变;但 Gaussian 编码是圆,GWD 始终为 0。它无法做高精度角度区分。

八、旋转目标检测的边缘路线:EWD

8.1 EWD 为什么不再把整个框当 Gaussian

对精确正方形,整框 Gaussian 的协方差为 \(a^2I\),角度被完全消去。EWD 改为把概率质量放在矩形 或多边形的边界上。

EWD 论文把密度写成3

\[ p(x,y)= \begin{cases} \tilde p(x,y),&(x,y)\in\mathbf E,\\ 0,&\text{其他位置}, \end{cases} \]

并要求

\[ \int_{\mathbf E}\tilde p(x,y)\,\mathrm ds=1. \tag{8.1} \]

严格地说,边界在二维平面中的面积为 0,所以这不是相对于二维面积 \(\mathrm dx\mathrm dy\) 的普通密度,而是一个以弧长 \(\mathrm ds\) 为基准、支撑在曲线 \(\mathbf E\) 上的一维概率测度。

8.2 为什么它只是受约束的 Wasserstein 近似

真实 \(W_2^2\) 允许任意边上的质量运到另一多边形的任意位置。要严格比较全局距离与逐边距离,必须先写清每条边携带多少概率质量。设

\[ P=\sum_{i=1}^k a_iP_i, \qquad Q=\sum_{i=1}^k a_iQ_{\pi(i)}, \qquad a_i\ge0, \quad \sum_{i=1}^k a_i=1, \tag{8.2} \]

其中每个 \(P_i,Q_j\) 都是归一化为质量 1 的单边概率分布,\(a_i\) 才是该边在整条边界中的质量。 对每一对匹配边取一个最优耦合 \(\gamma_i\in\Pi(P_i,Q_{\pi(i)})\),并把它们混合:

\[ \gamma=\sum_{i=1}^k a_i\gamma_i. \]

验证第一个边缘时,才需要把第 2 节的“只看起点,不管终点”写成严格的集合形式。任取平面中的一个区域 \(A\):

  • \(P(A)\) 表示起点落在区域 \(A\) 中的概率;
  • \(A\times\mathbb R^2\) 表示“起点在 \(A\) 中,而终点可以在平面中的任何位置”;
  • 因此 \(\gamma(A\times\mathbb R^2)\) 表示在搭配规则 \(\gamma\) 下,起点落在 \(A\) 中的概率。

对每个区域 \(A\),这个概率都应当与 \(P(A)\) 相等。代入式 (8.2) 和各条边的耦合 \(\gamma_i\),得到

\[ \gamma(A\times\mathbb R^2) =\sum_i a_i\gamma_i(A\times\mathbb R^2) =\sum_i a_iP_i(A)=P(A). \]

第二个边缘同理等于 \(Q\),所以 \(\gamma\in\Pi(P,Q)\)。全局 \(W_2^2\) 是对所有合法耦合取最小,故不会大于这个特定逐边耦合的代价:

\[ \boxed{ W_2^2(P,Q) \le \sum_{i=1}^k a_i W_2^2(P_i,Q_{\pi(i)}). } \tag{8.2a} \]

再对允许的 \(\pi\) 取最小,不等式仍成立。这才是“逐边约束给出上界”的严格版本。若四条边等权,\(a_i=1/4\),则论文使用的未加权逐边和是式 (8.2a) 右端的 4 倍;它本身更适合作为缩放过的训练代理。若按边长分配质量,匹配边的质量还必须兼容;质量不同却仍强制一整条边只对一整条边时,不能直接把单边概率耦合相加成全局耦合。

EWD 进一步把 \(\pi\) 限制为保持环绕顺序的循环对应。对四边形只需遍历 4 个循环起点。这牺牲了无约束 OT 的所有跨边运输方案,换取边语义、方向信息和可计算性3。以下继续沿用论文的未加权训练代理,并用波浪号与精确全局 \(W_2^2\) 区分。

8.3 EGWD:把每条边看成秩为 1 的 Gaussian

一条边用中心 \(c_i\in\mathbb R^2\) 和有向边向量 \(e_i\in\mathbb R^2\) 表示。EWD 为它构造

\[ P_i=\mathcal N(c_i,\Sigma_i), \qquad \Sigma_i=\frac14e_ie_i^\top. \tag{8.3} \]

\(\Sigma_i\) 只有一个非零特征值,是秩为 1 的退化 Gaussian:概率只沿边方向变化,垂直方向方差为0。式 (4.1) 对半正定协方差仍成立。

设 \(e_i=l_iu_i\),其中 \(l_i=\|e_i\|_2\)、\(\|u_i\|_2=1\)。记投影矩阵\(P_i=u_iu_i^\top\)。因为

\[ P_i^2 =u_i(u_i^\top u_i)u_i^\top =u_iu_i^\top=P_i, \]

式 (8.3) 的主平方根就是

\[ \Sigma_i^{1/2}=\frac{l_i}{2}P_i, \]

因为 \((l_iP_i/2)^2=l_i^2P_i/4=\Sigma_i\)。同时

\[ \operatorname{Tr}(\Sigma_i)=\frac{l_i^2}{4}. \]

现在把两条边的协方差耦合项逐步相乘:

\[ \begin{aligned} \Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2} &=\left(\frac{l_1}{2}P_1\right) \left(\frac{l_2^2}{4}P_2\right) \left(\frac{l_1}{2}P_1\right)\\ &=\frac{l_1^2l_2^2}{16}P_1P_2P_1. \end{aligned} \]

而

\[ \begin{aligned} P_1P_2P_1 &=u_1u_1^\top u_2u_2^\top u_1u_1^\top\\ &=(u_1^\top u_2)^2u_1u_1^\top =(u_1^\top u_2)^2P_1. \end{aligned} \]

所以主平方根必须取非负系数:

\[ \left(\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2}\right)^{1/2} =\frac{l_1l_2|u_1^\top u_2|}{4}P_1. \]

\(P_1\) 是秩 1 投影,\(\operatorname{Tr}(P_1)=1\),故

\[ \operatorname{Tr}\!\left[ (\Sigma_1^{1/2}\Sigma_2\Sigma_1^{1/2})^{1/2} \right] =\frac{|e_1^\top e_2|}{4} =\frac{l_1l_2|\cos\Delta\theta|}{4}. \tag{8.4} \]

所以严格的秩 1 Gaussian \(W_2^2\) 是

\[ \boxed{ W_2^2(P_1,P_2) =\|c_1-c_2\|_2^2 +\frac14\left( \|e_1\|_2^2+\|e_2\|_2^2-2|e_1^\top e_2| \right). } \tag{8.5} \]

也可写成

\[ W_2^2(P_1,P_2) =\|c_1-c_2\|_2^2 +\frac14\min\{\|e_1-e_2\|_2^2,\|e_1+e_2\|_2^2\}. \tag{8.6} \]

Gaussian 线段分布本身没有箭头方向,所以 \(e\) 和 \(-e\) 应表示同一协方差,这就是绝对值/最小值的来源。

EWD 附录把 \(\sqrt{\cos^2\Delta\theta}\) 直接写成 \(\cos\Delta\theta\),进而得到

\[ \widetilde W_{12} =\|c_1-c_2\|_2^2+\frac14\|e_1-e_2\|_2^2. \tag{8.7} \]

式 (8.7) 只有在选定的有向边对应保证 \(e_1^\top e_2\ge0\) 时才和式 (8.5) 相同。若把有向边序列本身视为表示的一部分,式 (8.7) 可以作为方向敏感代理;但不能无条件称为两个秩 1 Gaussian 的精确\(W_2^2\)。

8.4 从四条边求和到 OBB 的 EGWD 公式

令框中心为 \(o\),宽向量为 \(u\),高向量为 \(v\);这里 \(\|u\|=w,\|v\|=h,u\perp v\)。按一个固定环绕方向,四条边中心可写成

\[ c_1=o-v/2, \quad c_2=o+u/2, \quad c_3=o+v/2, \quad c_4=o-u/2. \tag{8.8} \]

对预测和真值的同名量作差,记为 \(\Delta o,\Delta u,\Delta v\)。四个中心误差之和为

\[ \begin{aligned} &\|\Delta o-\Delta v/2\|^2 +\|\Delta o+\Delta u/2\|^2\\ &+\|\Delta o+\Delta v/2\|^2 +\|\Delta o-\Delta u/2\|^2. \end{aligned} \]

成对展开:

\[ \|a-b/2\|^2+\|a+b/2\|^2 =2\|a\|^2+\frac12\|b\|^2, \]

所以中心部分等于

\[ 4\|\Delta o\|^2 +\frac12\|\Delta u\|^2 +\frac12\|\Delta v\|^2. \tag{8.9} \]

两条宽边各贡献 \(\frac14\|\Delta u\|^2\),两条高边各贡献\(\frac14\|\Delta v\|^2\)。与式 (8.9) 相加:

\[ \boxed{ \widetilde W_{\mathrm{EGWD}} =4\|\Delta o\|_2^2 +\|\Delta u\|_2^2 +\|\Delta v\|_2^2. } \tag{8.10} \]

对每个允许的循环边匹配都算一次式 (8.10),再取最小值。若

\[ u=w\begin{bmatrix}\cos\theta\\\sin\theta\end{bmatrix}, \qquad v=h\begin{bmatrix}-\sin\theta\\\cos\theta\end{bmatrix}, \]

则固定对应下

\[ \|\Delta u\|^2=w_p^2+w_g^2-2w_pw_g\cos(\theta_p-\theta_g), \tag{8.11} \]

高向量同理。即使 \(w=h\),任意非对称角度差仍会产生非零代价;而相差 \(\pi/2\) 的同一正方形可以通过循环移动边序列得到零代价,符合正方形的四重对称性。

8.5 EDWD:让对应边上的同一归一化位置相互运输

EDWD 不要求边上分布是 Gaussian。把一条边参数化为

\[ X_i=c_i+\frac{x}{2}e_i, \qquad x\in[-1,1]. \]

对一对边,强制两个采样点使用同一个 \(x\):

\[ X_1=c_1+\frac{x}{2}e_1, \qquad X_2=c_2+\frac{x}{2}e_2. \]

记 \(\Delta c=c_1-c_2,\Delta e=e_1-e_2\),则

\[ \begin{aligned} \|X_1-X_2\|^2 &=\left\|\Delta c+\frac{x}{2}\Delta e\right\|^2\\ &=\|\Delta c\|^2 +x\Delta c^\top\Delta e +\frac{x^2}{4}\|\Delta e\|^2. \end{aligned} \tag{8.12} \]

若 \(p(x)\) 关于 0 对称,则

\[ \mathbb E[x]=0, \qquad \mathbb E[x^2]=\sigma^2. \]

对式 (8.12) 取期望:

\[ \boxed{ \widetilde W_{\mathrm{EDWD},12} =\|\Delta c\|^2 +\frac{\sigma^2}{4}\|\Delta e\|^2. } \tag{8.13} \]

例如边上均匀采样 \(x\sim U[-1,1]\) 时,

\[ \sigma^2=\mathbb E[x^2] =\frac12\int_{-1}^{1}x^2\,\mathrm dx =\frac13. \]

将四条边的式 (8.13) 与中心和式 (8.9) 合并:

\[ \boxed{ \widetilde W_{\mathrm{EDWD}} =4\|\Delta o\|^2 +\left(\frac12+\frac{\sigma_w^2}{2}\right)\|\Delta u\|^2 +\left(\frac12+\frac{\sigma_h^2}{2}\right)\|\Delta v\|^2. } \tag{8.14} \]

EGWD 与 EDWD 最终长得相似,但来源不同:前者来自边的秩 1 Gaussian \(W_2\),后者来自强制同一归一化位置的确定耦合。

8.6 EWD 怎样变成训练 loss

论文报告直接使用平方代价很难收敛,因此还做两步工程处理。

第一步是尺度归一:

  • 中心差除以 \(s=\sqrt{w_gh_g}\);
  • 预测宽高变成 \(w_p/w_g,h_p/h_g\),真值宽高归一成 1;
  • 边分布方差也按真值尺度调整。

一种清楚的向量写法是先构造

\[ \Delta\tilde o=\frac{o_p-o_g}{\sqrt{w_gh_g}}, \]
\[ \Delta\tilde u =\frac{w_p}{w_g} \begin{bmatrix}\cos\theta_p\\\sin\theta_p\end{bmatrix} -\begin{bmatrix}\cos\theta_g\\\sin\theta_g\end{bmatrix}, \]
\[ \Delta\tilde v =\frac{h_p}{h_g} \begin{bmatrix}-\sin\theta_p\\\cos\theta_p\end{bmatrix} -\begin{bmatrix}-\sin\theta_g\\\cos\theta_g\end{bmatrix}, \]

再把这些无量纲量代入式 (8.14)。具体的 \(\sigma_w^2,\sigma_h^2\) 权重是论文的设计超参数。

第二步是后处理函数。论文比较

\[ f(x)\in \left\{x,\sqrt{x},\log(1+x),1-\frac{1}{\tau+x}\right\}, \]

并称多数实验采用

\[ \boxed{ \mathcal L_{\mathrm{EWD}} =\log(1+\widetilde W_{\mathrm{EDWD,norm}}). } \tag{8.15} \]

然后像其他框 loss 一样,只对正样本求平均并与分类 loss 加权相加。

8.7 EWD v1 中必须显式保留的公式问题

为了不把排版或隐含假设变成“定理”,复现时要注意:

  1. 论文把 \(\inf\mathbb E\|X-Y\|^2\) 记作 \(W\),它实际对应本文的 \(W_2^2\),没有最外层平方根。
  2. EGWD 附录把 \(\sqrt{\cos^2\Delta\theta}\) 化成 \(\cos\Delta\theta\),漏写绝对值;只有选定方向使内积非负时才成立。
  3. 正文列出的部分边中心坐标存在 \(w/h\) 或正负号不一致。向量式 (8.8) 与附录式更自洽,本文采用向量式。
  4. \(x\in[-1,1]\) 时,\(\sigma^2=\mathbb E[x^2]\) 应是无量纲且不超过 1;正文又说把方差直接设为边长 \(w,h\)。只有先归一化或把它理解成权重而非严格概率方差,量纲才一致。
  5. 未归一式的中心项系数是 4,对应梯度应含系数 8;尺度归一段展示的中心梯度系数是 2,说明该段 还做了未完整写出的重标定。论文没有给出可核对的官方代码链接,v1 文字不足以唯一恢复所有系数。

因此,式 (8.10)、式 (8.13)、式 (8.14) 可以从论文假设严格推导;具体归一化 EWD 的复现则必须采用报告采用的系数,不应把某个猜测实现称为唯一官方公式。

总结

本来后面还想说一些关于高斯框扩展阅读的东西,但一想到这篇文章的篇幅,就写到这里吧。 感谢读者能读到这里,本文最主要的讲的是二维高斯Wasserstein距离的推导。 后续的文章会新开一篇关于高斯框相关的内容,不再局限在Wasserstein距离上面,敬请期待,如果本文有什么问题或者错误,恳请评论批评指正。

参考文献


  1. Xue Yang, Junchi Yan, Qi Ming, Wentao Wang, Xiaopeng Zhang, Qi Tian. “Rethinking Rotated Object Detection with Gaussian Wasserstein Distance Loss.” ICML, 2021. ↩↩↩↩↩↩↩

  2. Jinwang Wang, Chang Xu, Wen Yang, Lei Yu. “A Normalized Gaussian Wasserstein Distance for Tiny Object Detection.” 2021. ↩↩↩↩↩↩↩

  3. Yuke Zhu et al. “Edge Wasserstein Distance Loss for Oriented Object Detection.” arXiv:2312.07048v1, 2023. ↩↩↩↩↩

  4. Clark R. Givens, Rae Michael Shortt. “A Class of Wasserstein Metrics for Probability Distributions.” Michigan Mathematical Journal, 31(2):231--240, 1984. ↩↩

  5. Zheng Ge et al. “OTA: Optimal Transport Assignment for Object Detection.” CVPR, 2021. ↩

  6. D. C. Dowson, B. V. Landau. “The Fréchet Distance between Multivariate Normal Distributions.” Journal of Multivariate Analysis, 12(3):450--455, 1982. ↩

  7. Ingram Olkin, Friedrich Pukelsheim. “The Distance between Two Random Vectors with Given Dispersion Matrices.” Linear Algebra and its Applications, 48:257--263, 1982. ↩

  8. Djalil Chafaï. “Wasserstein Distance between Two Gaussians.” 2010. 教学型二级来源,仅作证明路线交叉核对。 ↩

  9. Martin Knott, Cyril S. Smith. “On the Optimal Mapping of Distributions.” Journal of Optimization Theory and Applications, 43(1):39--49, 1984. ↩

  10. OpenMMLab. “MMRotate Gaussian Distance Loss Implementation.” GitHub repository, accessed 2026-07-18. ↩

  11. Jinwang Wang et al. “NWD Official Implementation.” GitHub repository, accessed 2026-07-18. ↩↩

  12. Chang Xu et al. “Detecting Tiny Objects in Aerial Images: A Normalized Wasserstein Distance and a New Benchmark.” ISPRS Journal of Photogrammetry and Remote Sensing, 2022. ↩

评论

滚动到评论区附近时自动加载