Wasserstein 距离与目标检测(二):Gaussian 框距离、表示方法与相关损失
⏱ 约 67 分钟本文整理于2026年10月08日,由AI和本人共同完成,本人负责把推导详细顺了一遍
前言
本文接续第一篇:二维 Gaussian 分布 Wasserstein 距离的推导及其在目标检测中的应用。第一篇从耦合定义出发,完整证明了 Gaussian 的二阶 Wasserstein 距离,并逐步解释 GWD、NWD 和 EWD 123。本篇把问题推进一步:如果仍把框编码成 Gaussian,但把比较方式换成 KLD、Bhattacharyya/Hellinger 或 Gaussian product,会得到什么? 如果问题来自表示而非距离,又应该怎样修改检测头?如果不经过 Gaussian 编码,能否直接比较 多边形几何?下文围绕这些问题,逐步串起距离、表示与最终损失之间的关系。
记号与第一篇一致:均值只写作 \(\mu\),协方差写作 \(\Sigma\);预测与真值分别使用下标 \(p,g\); 一般的两个分布使用下标 \(1,2\)。因此下文对论文公式做了等价改写,不机械保留原文中的 \(m\)、\(t\) 或含混的 \(W\)。这只统一表示,不改变被引用方法的数学内容。
零、方法概览
一个定位损失至少有四层:
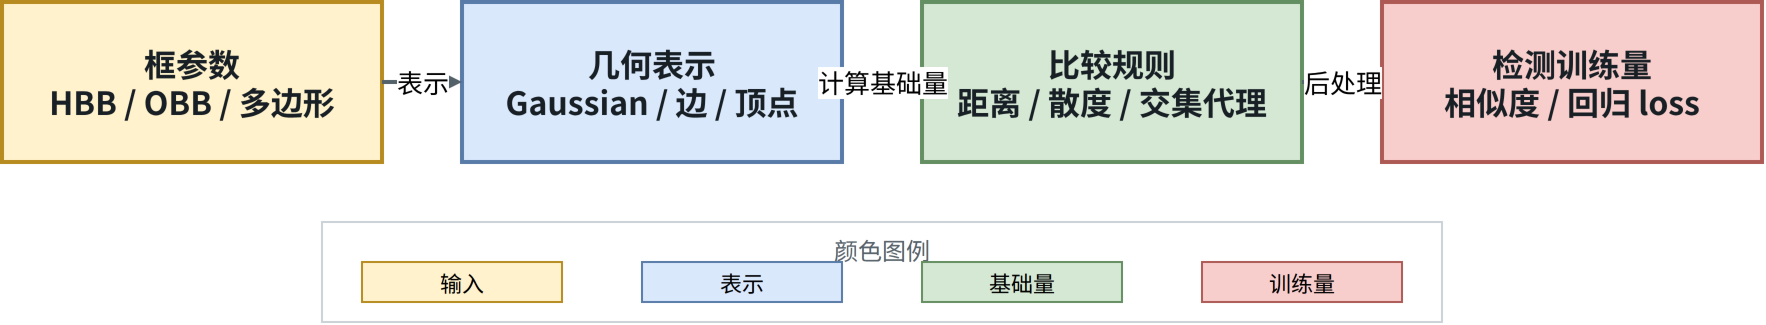
GWD、NWD 和 EWD 分别位于这条链的不同位置 123。扩展论文也不能只按名称比较:
| 方法 | 表示层 | 基础量 | 最终用途 |
|---|---|---|---|
| GWD 1 | 整框 Gaussian | 精确 Gaussian \(W_2^2\) | OBB 回归 |
| NWD/NWD-RKA 29 | 水平框 Gaussian | 精确 \(W_2\) | 相似度、回归、分配、NMS |
| EWD 3 | 四条边的支撑分布 | 受边对应约束的运输代理 | OBB 回归 |
| KLD 4 | 整框 Gaussian | 有方向的 KL 散度 | OBB 回归 |
| ProbIoU 5 | 区域二阶矩 Gaussian | Bhattacharyya/Hellinger | 有界相似度与回归 |
| KFIoU 6 | 整框 Gaussian | Gaussian product 的体积代理 | 近似 SkewIoU |
| MKIoU 7 | 同 KFIoU,外加角度项 | 调制后的 KFIoU | OBB 回归 |
| G-Rep 8 | 任意点集的 MLE Gaussian | KLD、BD 或 WD | QBB/点集回归与分配 |
| LGBB/GauCho 1113 | 直接回归矩阵坐标 | 可搭配多种 Gaussian loss | 改造检测头 |
| Structure Tensor 12 | 人工各向异性张量 | 元素级 \(L_1\) | 单独的角度分支 |
| GCD 14 | 水平框 Gaussian 参数 | 对称、相对归一的代理 | 微小水平框相似度 |
| P2P 15 | 凸多边形 | 三角形面积和 | 直接几何回归 |
因此,“使用 Gaussian”不等于“使用 Wasserstein”。同一个 Gaussian 表示可以搭配不同的 比较基础量;把某个相似度用于标签分配,也不等于重新定义了框之间的距离。
0.1 阅读前先认识计算链上的对象
先用一个具体场景理解上表。图像里有一个人工标注框,检测器也输出了一个预测框。训练时,我们先把网络输出解码成中心、宽高和角度,再比较预测与标注;损失越大,表示这一对框在选定标准下偏差越大。这里的 GT(ground truth) 就是真值标注;HBB 是水平框;OBB 是允许旋转的矩形框;QBB 是用四个顶点表示的四边形框,未必是矩形。Anchor 是预先设置的参考框,后文统称需要判断“归哪个真值负责”的框为候选框。并非所有检测器都使用 anchor。
因此,图 0-1 可以不用看图就读成:
例如,NWD 先把框变成 Gaussian,再算 \(W_2\),最后算 \(\exp(-W_2/C)\)。最后这个数越大越相似, 而回归时通常希望“越差损失越大”,所以还要取 \(1-\exp(-W_2/C)\)。相似度、距离与损失虽然可能 能相互换算,但不是同一个数学对象。标签分配则更早一步:决定哪些预测框参与哪一个真值的回归。 第 7.1 节的 NWD-RKA 讨论的就是这个问题,而非又定义一个定位损失。
0.2 本文反复使用的矩阵记号
二维 Gaussian 写成 \(\mathcal N(\mu,\Sigma)\)。均值 \(\mu\) 是两个中心坐标,协方差 \(\Sigma\) 是一个对称的 \(2\times2\) 矩阵:对角线描述沿两个坐标轴的离散程度,非对角线描述两个 坐标怎样共同变化。对框来说,它是我们主动选择的形状编码,不意味着网络估计了定位不确定性。
后文几种记号可以先用二维情形记住:
\(\operatorname{Tr}\) 称为迹,是对角线元素之和;\(\det\) 是行列式,有时也写作 \(|\Sigma|\), 此处不是逐元素取绝对值。\(\Sigma\succ0\) 表示正定,即任何非零向量 \(z\) 都满足 \(z^\top\Sigma z>0\);二维时等价于 \(a>0,ab-c^2>0\)。这个条件保证 Gaussian 在任何方向都有正的 宽度,也保证逆矩阵和后面的对数行列式有意义。\(I\) 表示单位矩阵,\(\top\) 表示转置。
把坐标轴转到椭圆主轴后,协方差成为对角矩阵;对角线上两个数就是特征值,平方根才是两个方向的 标准差。若坐标单位是像素,\(\mu\)、标准差和 \(W_2\) 的单位是像素,协方差元素和 \(W_2^2\) 的单位是 像素平方。\(\Sigma^{-1}\) 则负责除去尺度:\(z^\top\Sigma^{-1}z\) 是无量纲的加权平方误差。
本文 \(\log\) 均为自然对数,\(\exp\) 是它的反函数。对数中的密度比、行列式比等最终应是无量纲量。 对单个有单位的行列式分别取对数,只是合并对数比的代数写法;不要把其中一项单独当作具有坐标 无关含义的损失。矩阵乘法的次序也必须保留,通常 \(AB\ne BA\)。
一、先固定共同表示:同一个框至少有两种 Gaussian 映射
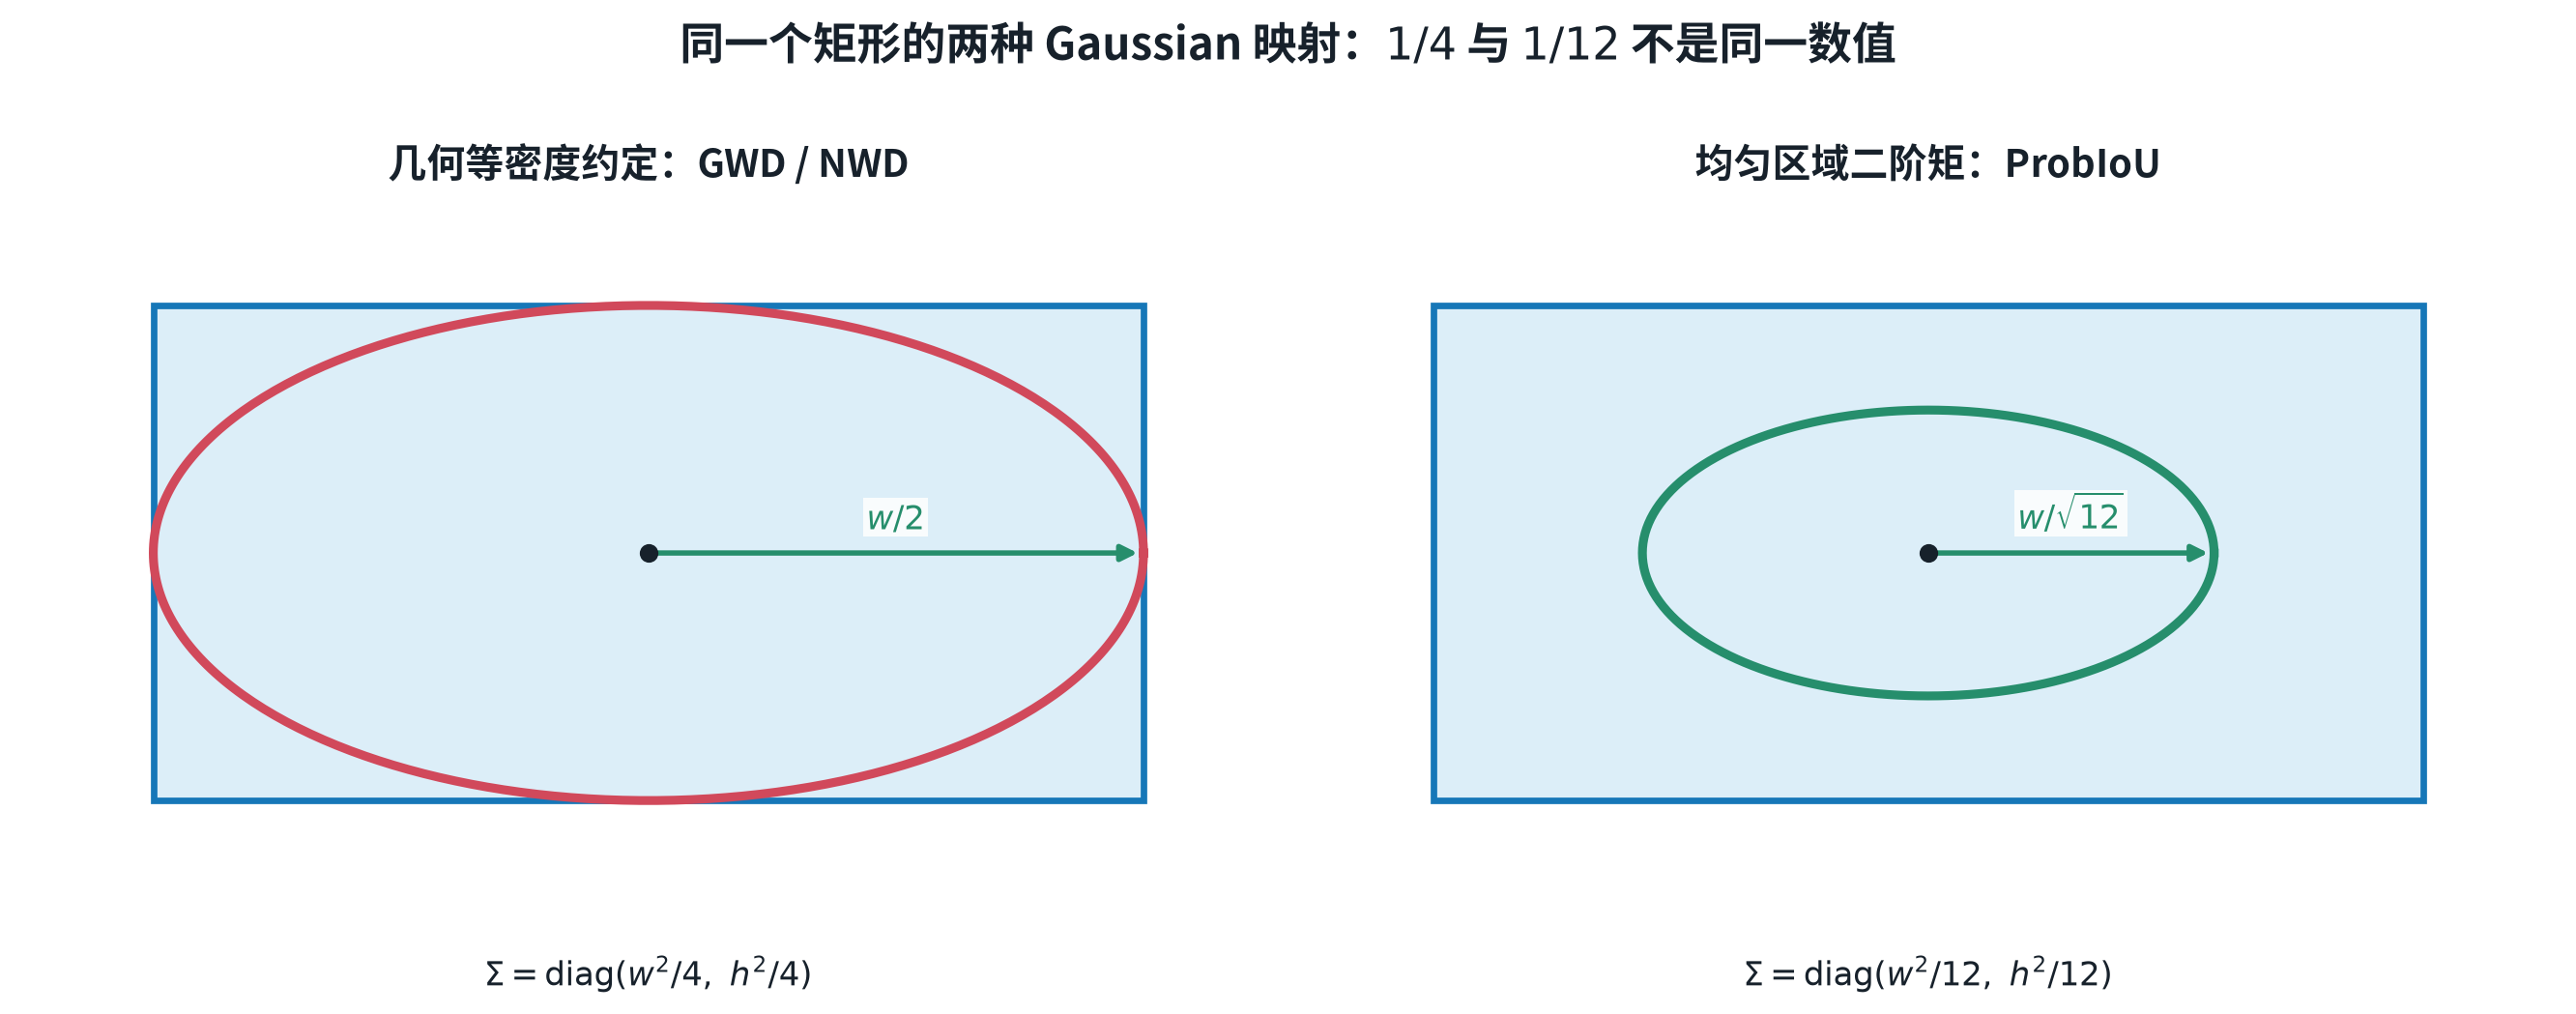
1.1 几何等密度椭圆映射:\(1/4\)
从这一章开始,先不讨论谁的损失更好,而是固定“同一个框到底变成什么分布”。否则,两篇论文的结果可能只是编码不同,并非比较公式不同。设框的局部坐标轴沿着两条边,先在局部坐标中规定 Gaussian 的宽度,再旋转和平移到图像坐标。
设旋转框
旋转矩阵为
GWD、KLD、KFIoU 等旋转检测工作常采用下面的映射;NWD 使用其 \(\theta=0\) 的水平框情形:
这里先取局部随机向量 \(Z\),令其均值为 0、协方差为 \(D=\operatorname{diag}(w^2/4,h^2/4)\),再令 \(X=\mu+R_\theta Z\)。根据协方差的定义,
这解释了式 (1.2) 为什么在对角矩阵左右各放一个旋转因子。式中的 \(w/2,h/2\) 是沿框的主轴的 标准差;框旋转后,它们一般不再等于图像 \(x,y\) 坐标方向的标准差。
因为 \(\Sigma_{1/4}\) 的两个标准差是 \(w/2\) 与 \(h/2\),Mahalanobis 等值线
恰好具有半轴 \(w/2,h/2\)。这是几何编码约定,不是说矩形内部像素真的按 Gaussian 采样 1246。
1.2 均匀矩形的二阶矩映射:\(1/12\)
ProbIoU 的出发点不同:先把矩形区域上的均匀分布压缩成具有相同均值、协方差的 Gaussian 5。 在一维上令
其均值为
方差为
矩形局部坐标的两个分量独立,故其协方差为
校正:改变协方差的公共倍数,不等于共同缩放坐标。 式 (1.2) 与式 (1.5) 的协方差相差 因子 \(3\),但它们的中心不变。对 KLD 和 Bhattacharyya 距离,公共因子只在形状比较项中抵消, 在中心误差项中并不抵消。两框同中心时整个量才不受这一公共协方差因子影响。
为了看清区别,暂写 \(\Sigma_i=sS_i\),其中 \(S_i\) 固定。第 2、3 章将分别推出
这里 \(\Delta\mu=\mu_p-\mu_g\),\(d=2\)。暂时不需要记住整个公式,只需看到中心项前面还留着 \(1/s\):将 \(s\) 从 \(1/4\) 改为 \(1/12\),相同中心误差受到的惩罚变为原来的三倍。
例如,两个 \(2\times2\) 水平框的中心分别为 \((0,0)\) 和 \((1,0)\)。用 \(1/4\) 映射时,两协方差都是 \(I\),得到 \(D_{\rm KL}=1/2,D_B=1/8\);用 \(1/12\) 映射时,两协方差都是 \(I/3\),得到 \(D_{\rm KL}=3/2,D_B=3/8\)。这是一组无需矩阵运算就能核查的反例。
真正的共同坐标缩放是 \(\mu_i\mapsto a\mu_i\)、\(\Sigma_i\mapsto a^2\Sigma_i\),中心误差也同时 缩放,此时 KLD、Bhattacharyya 距离才保持不变。\(W_2\) 则变为原来的 \(|a|\) 倍。单独改变编码中的 \(s\) 一般也会改变 \(W_2\) 的形状项,但并非所有例子都会改变:上面两框只有平移,\(W_2=1\),与 \(s\) 无关。实现时不能混用两种映射后仍声称得到了同一论文公式。
1.3 一个统一参数 \(s\)
后文可把二者写成
于是
这些恒等式会反复用于 KLD、Bhattacharyya 和 Gaussian product 的推导。
1.4 不可能性定理:整框二阶矩无法恢复正方形角度
定理 1.1(各向同性造成方向不可辨)。若 \(w=h=a\),则任何只依赖 \((\mu,\Sigma_s)\) 的函数都不能区分同中心、同尺寸、不同角度的正方形。
证明。 此时
与 \(\theta\) 无关。若两个正方形只有角度不同,则它们的 \(\mu\) 与 \(\Sigma_s\) 完全相同。对任意函数 \(F(\mu_1,\Sigma_1,\mu_2,\Sigma_2)\),输入相同必然输出相同,故不可能从输出反推出角度。证毕。
这个结论与选用 \(W_2\)、KLD、Hellinger 还是 Gaussian product 无关。MKIoU、EWD、Structure Tensor 和 anisotropic GBB 的共同动机,正是绕开式 (1.8) 的信息丢失 371216。
二、KLD:同一 Gaussian 表示,换成有方向散度
2.1 定义与方向
上一章固定了 Gaussian 编码,现在只替换“怎么比较”。Wasserstein 的问题是把一个分布搬成另一个要付出多少成本;KLD 换了一个问题:从 \(P\) 中经常出现的位置来看,\(Q\) 对这些位置给出的密度是否也足够大? 因此它并不需要求运输计划。
在某个位置,\(p(x)/q(x)\) 表示两个密度的相对大小;对数把相乘的比例变为可相加的差异。再用 \(p(x)\) 加权,表示按照 \(P\) 的出现频率求平均。单个位置的对数比可以为负,但整个平均值非负。
对密度 \(p,q\),Kullback--Leibler 散度定义为 17
它一般不对称:\(D_{\mathrm{KL}}(P\|Q)\ne D_{\mathrm{KL}}(Q\|P)\),所以数学上称“散度”而非 “距离”。旋转检测论文分别讨论 prediction-to-target 与 target-to-prediction 两个方向,主设置通常 选择前者 4。
2.2 \(d\) 维 Gaussian KLD:逐项积分
令
其中协方差正定。\(d\) 维 Gaussian 密度是
\(g(x)\) 同理。先取对数比:
下面对 \(X\sim P\) 求期望。先解释为什么要改变二次型的写法。
这里会出现“随机向量的二次型”。先解释为什么要把它改写成迹:\(z^\top Az\) 是一个标量,而 \(zz^\top\) 是矩阵,后者的期望恰好能用协方差表示。下面的改写就是把复杂积分交给已经知道的均值和协方差,不是引入一个新的近似。
得到
令 \(\Delta\mu=\mu_p-\mu_g\),则
展开第三个二次型:
因为 \(\mathbb E[X-\mu_p]=0\),中间交叉项期望为 0;第一项按式 (2.4) 处理:
将式 (2.5)--(2.7) 代入式 (2.3):
二维时 \(d=2\),所以论文公式末尾是 \(-1\):外层 \(1/2\) 乘上括号中的 \(-2\) 4。
2.3 为什么 KLD 非负
非负性不需要 Gaussian 假设。这里先在密度处处为正的情形证明,因而覆盖本文的非退化 Gaussian。 令 \(f(u)=u-1-\log u\)。它的导数是 \(f'(u)=1-1/u\),在 \(0<u<1\) 时为负,在 \(u>1\) 时为正, 所以 \(u=1\) 是全局最小点,且 \(f(1)=0\)。这就得到下面的不等式。
使用基本不等式
令 \(u=q(x)/p(x)\),则
两边乘 \(p(x)\) 并积分:
式 (2.9) 只在 \(u=1\) 取等,因此在两密度互相绝对连续时,KLD 为 0 当且仅当 \(p=q\) 几乎处处。
2.4 旋转框标量展开
采用式 (1.2),即
由于 \(R_g^{-1}=R_g^\top\),
把中心误差旋转到真值框的局部坐标:
于是 Mahalanobis 项为
这说明沿真值长轴和短轴的同样像素偏差会得到不同权重。
再令
利用迹的循环不变性:
把“直接相乘”的关键一步展开。令 \(c=\cos\Delta\theta,t=\sin\Delta\theta\),先只计算中间 旋转后的预测协方差的两个对角元素:
左边再乘对角矩阵,相当于分别将这两个元素乘以 \(4/w_g^2\) 和 \(4/h_g^2\);求迹就是相加。非对角元素不进入这次求迹,因此不用把四个元素都算出来。
直接乘开 \(2\times2\) 矩阵,得到
最后由式 (1.7):
将式 (2.13)、(2.15)、(2.16) 逐项代入式 (2.8),得到无需读者再拼接的标量式 4:
最简单的检查是代入完全相同的框:中心项为 0、余弦项为 1、正弦项为 0、对数项为 0,最后\(1-1=0\)。如果只改变中心,则只剩前两个加权平方误差;如果只旋转预测框,则变化只在中间两项。
2.5 梯度耦合:不是五个独立误差
“梯度耦合”说的是:某个参数该改多少,会受其他参数影响。对于很细长的真值框,跨过短边的一像素偏差可能很严重,沿长边的一像素偏差则不那么严重。KLD 不是给两个方向使用同一个固定权重,而是由真值框的宽高和方向来确定权重。下面的求导把这一直觉写成可计算的量。
先看中心。由式 (2.8):
当 \(\theta_g=0\) 时,
短边越短,相应方向的中心误差梯度越大。再对网络常回归的 \(\log w_p,\log h_p\) 求导。 先令求导变量 \(z=\log w_p\),即 \(w_p=e^z\),所以 \(\partial/\partial z=w_p\,\partial/\partial w_p\)。若改为直接对 \(w_p\) 求导,结果还要 除以 \(w_p\);两种梯度不能混为一谈。由此得到 \(\partial w_p^2/\partial\log w_p=2w_p^2\),再对式 (2.15)、(2.16) 的相应项求导,得到
角度只出现在迹项。利用
有
当预测尺寸已经等于真值尺寸时,令 \(r=w_g/h_g\):
因此长宽比越极端,角度梯度越强;当 \(r=1\),角度梯度严格为 0,这再次证明正方形方向退化。 不同论文有时把 \(D_{\mathrm{KL}}\) 外的常数 \(1/2\) 吸收到 loss 权重中,所以会看到不带 \(1/2\) 的等价梯度式;比较时必须先统一 KLD 定义。
2.6 严格的共同仿射不变性
令 \(M\) 为可逆矩阵,对两个随机向量同时施加
其中 \(b\) 是两个分布共同的平移向量。这里的“共同”很重要:同一个 \(M,b\) 同时作用在两边, 不是单独改变预测框。相减后 \(b\) 抵消,故 \(\Delta\mu'=M\Delta\mu\)。例如坐标单位从像素改成 另一长度单位,并不应该改变无量纲的 KLD;第 1.2 节只放大协方差、保持中心不动的操作却不是 这种坐标变换。
中心项变为
迹项为
行列式比中 \(\det(M)^2\) 抵消:
所以
取 \(M=\alpha I\) 就得到严格共同尺度不变性。与之相对,原始 \(W_2\) 在共同缩放后乘以 \(|\alpha|\),NWD 只有在归一常数 \(C\) 同时缩放时才严格不变。
这里证明的是 Gaussian 分布被共同仿射变换后的性质。一般剪切会把矩形变成平行四边形; 若再拟合一个外接旋转矩形并重新编码,就额外改变了对象,不能直接套用这个不变性结论。
2.7 从散度到论文 loss
KLD 检测工作采用和 GWD 相似的后处理族 4:
其中 \(f(D)=\sqrt D\) 或 \(\log(1+D)\)。这是论文设计,不是 KLD 的定义。两者都将较大的散度 压缩,外层分式又使损失有上界。若采用式 (2.28) 且要求完美匹配时损失为 0,应取 \(\tau=1\); \(\tau=2\) 时,完美匹配的常数基线是 \(1/2\)。
要区分“减去常数基线”和“改变 \(\tau\)”。 固定 \(\tau\) 后减去 \(1-1/\tau\),得到
这个平移不改变梯度,只改变日志中的零点。但把 \(\tau\) 从 1 改成 2 会改变梯度,因为在可微处
因此不能把不同 \(\tau\) 的两个损失仅理解为相差一个常数。若 \(f(D)=\sqrt D\),式 (2.30) 先在 \(D>0\) 使用,完美匹配处需分析复合函数或明确数值稳定化方式。
三、Bhattacharyya、Hellinger 与 ProbIoU:从积分完整推导
3.1 三个量的定义
KLD 有方向性,因此接下来考虑一种对称比较:不再问“由谁来给谁打分”,而是看两个密度在 相同位置能共同给出多少权重。几何平均 \(\sqrt{p(x)q(x)}\) 对交换 \(p,q\) 不变;某一方密度很小, 这一位置的贡献就很小。将它累加,便得到下面的重合系数。
对两个密度 \(p,q\),Bhattacharyya 系数定义为 518
它为什么落在 \([0,1]\)?非负性由被积函数非负得到;再由 Cauchy--Schwarz 不等式,
相同分布给出 \(BC=1\)。它越接近 1 越相似,不符合“相同对象的距离等于 0”的习惯,因此再通过 负对数或平方根把它变成差异量。
Bhattacharyya 距离是
Hellinger 距离采用本文与 ProbIoU 相同的归一化:
式 (3.3) 的第二个等号来自
式 (3.3) 中 \(\|h\|_{L^2}=\sqrt{\int h(x)^2\,\mathrm dx}\),是把有限维向量的欧氏范数推广到 函数。\(H\) 就是两个“平方根密度函数”之间的欧氏型距离,所以具有三角不等式。\(D_B\) 虽然名字 中也有“距离”,却一般不是严格的数学度量:取方差均为 1、均值依次为 \(0,1,2\) 的三个一维 Gaussian,由后面的式 (3.21) 可得两段 \(D_B\) 都为 \(1/8\),直接跨两段却是 \(1/2>1/8+1/8\)。 不要把 Hellinger 的度量性质自动赋给 Bhattacharyya 距离或 ProbIoU 相似度。
ProbIoU 论文定义 5
它是 Gaussian 区域的有界相似度,不是两个矩形或多边形的精确 IoU。
3.2 两个 Gaussian 的 Bhattacharyya 积分
令
且 \(\Sigma_1,\Sigma_2\) 正定。把密度代入式 (3.1):
这一段计算只做一件事:把两个 Gaussian 指数之和重新整理成一个 Gaussian 的指数。可以先回忆 一元配方 \(ax^2-2bx+c=a(x-b/a)^2+c-b^2/a\)。下面 \(A,b,c\) 分别扮演二次项、一次项和常数项 的系数;\(A\) 是矩阵,\(b\) 是向量,\(c\) 是标量。它们只是本节的临时记号,不是额外的检测参数。
定义
则指数中的二次型可写成
令 \(\hat\mu=A^{-1}b\),完成平方:
因此
最后的积分是未归一 Gaussian 积分:
式 (3.13) 也可以不用记忆。令 \(y=A^{1/2}(x-\hat\mu)\),则二次型变成 \(y^\top y\),体积微元 变成 \(\mathrm dx=(\det A)^{-1/2}\mathrm dy\)。剩下的积分是 \(d\) 个一维 Gaussian 积分的乘积, 每个 \(\int_{\mathbb R}e^{-y^2/2}\mathrm dy=\sqrt{2\pi}\),于是得到 \((2\pi)^{d/2}(\det A)^{-1/2}\)。这里 \(A\) 正定,因此主平方根存在且可逆。
接下来分别化简行列式和均值项。
3.2.1 行列式项
注意
故
令
则 \(\det\bar\Sigma=2^{-d}\det(\Sigma_1+\Sigma_2)\),所以
式 (3.12) 的全部行列式系数化为
3.2.2 均值项
积分对共同平移不变,可以令 \(\mu_2=0,\mu_1=\Delta\mu\)。此时
又因
有
括号内使用 parallel-sum 恒等式
下面把这个恒等式真正展开,而不是把矩阵因子当成标量交换。记 \(S=\Sigma_1+\Sigma_2\),则
因此 \((\Sigma_1^{-1}+\Sigma_2^{-1})^{-1}=\Sigma_1S^{-1}\Sigma_2\),再代回左侧:
这里第二行到第三行只是在第一项左边插入 \(S^{-1}S=I\)。于是
3.2.3 合并
把式 (3.16)、(3.19) 代回式 (3.12):
取负对数得到
这就是 ProbIoU 与 G-Rep 中使用的 Gaussian Bhattacharyya 闭式 58。
3.3 两种 ProbIoU loss 及其精确关系
由式 (3.2)--(3.5):
论文给出两种回归量 5:
二者不是近似关系,而是严格单调变换:
对任一框参数 \(z\),链式法则给出
当 \(D_B\) 很大时,\(e^{-D_B}\to0\),\(\mathcal L_1\to1\) 且梯度趋近 0,表现为远距离饱和; \(\mathcal L_2=D_B\) 不受这一有界变换压缩。当 \(D_B\to0\) 时,
所以
若 \(D_B\) 对参数误差是二次量,则 \(\mathcal L_1\) 局部类似绝对值,\(\mathcal L_2\) 局部类似平方误差。 式 (3.26) 的系数单独看会发散,但必须与 \(\partial D_B/\partial z\to0\) 一起看,不能据此直接断言 总体梯度发散。
3.4 水平框的显式式子
对水平框使用式 (1.5),写
则
式 (3.21) 第一项为
第二项为
式 (3.29) 中的 \(-\log2\) 来自 \(\det\bar\Sigma=((a_1+a_2)(b_1+b_2))/4\)。若把常数吸收到 一个合并对数中,它不会消失;完美匹配时正是它与其余项共同保证 \(D_B=0\)。
把第 1.2 节的两个 \(2\times2\) 框继续算完。中心相差 \((1,0)\),且采用 \(1/12\) 映射,所以 \(a_1=a_2=b_1=b_2=1/3\)。形状完全相同,行列式项为 0,故
这样就从框参数走完了“协方差—基础差异—相似度—损失”整条链。同一对真实矩形的交集面积是 \(1\times2=2\),并集面积是 \(4+4-2=6\),真实 IoU 为 \(1/3\),不是上面的 ProbIoU。
3.5 仿射不变性证明
对可逆 \(M\) 同时施加式 (2.23)。均值项与式 (2.24) 同理保持不变,因为 \(\bar\Sigma'=M\bar\Sigma M^\top\)。行列式比为
因此 \(D_B\)、\(BC\)、\(H\) 和 ProbIoU 都对共同可逆仿射变换不变。这是其无需 NWD 外部像素常数 \(C\) 的原因之一。
3.6 它与真实 IoU 的关系边界
若两个有限区域 \(\Omega_1,\Omega_2\) 上分别放置均匀离散分布,大小为 \(N,M\),则
真实 IoU 是
即使 \(N=M\),式 (3.31) 也为 \(I/N\),式 (3.32) 则为 \(I/(2N-I)\);二者不相等。 ProbIoU 的名字表达的是“类似 IoU 的概率相似度”,不是等式 (3.32) 的概率重写。
四、KFIoU:Gaussian 乘积为什么像“交集”,又为什么不是真交集
KFIoU 不再比较两个分布有多远,而是把两个 Gaussian 密度相乘,用乘积 Gaussian 的协方差体积 模拟旋转框交集 6。这一步与 Kalman 更新有相同代数形式,因而得名 KFIoU;它不是 Kalman 滤波器在检测器中随时间运行。
直觉上,乘积在“两边密度都高”的位置才大,因而看起来像取交集。但这里有一个容易漏掉的步骤: 乘积的总积分通常不是 1,要重新归一化才能成为概率分布。乘积整体有多大和归一化后有多宽 是两件事,KFIoU 的体积代理只保留后者。接下来先求后者,再说明这种取舍丢掉了什么。
4.1 从两个密度的乘积推导交集协方差
令
只看与 \(x\) 有关的指数,定义精度矩阵 \(\Lambda_i=\Sigma_i^{-1}\):
记
因为
式 (4.2) 与式 (4.4) 的前两项完全相同,最后一项只进入归一化常数。因此
符号 \(\propto\) 表示两边相差一个与 \(x\) 无关的正系数,并不是直接相等。完整形式是
它也可以通过与第 3.2 节相同的配方、积分步骤求出。这里 \(Z\) 会随着中心远离而下降,但 \(\Sigma_\cap\) 不随中心改变。故后文若只用 \(\Sigma_\cap\) 的行列式,乘积中原本存在的位置信息 就没有进入相似度。另须注意,\(Z\) 是密度乘积的积分,并不具有 Bhattacharyya 系数的 \([0,1]\) 上界,不能直接把二者互换。
式 (4.5) 还可写成论文所用的 Kalman 形式。先设
要证明
只需证明右边被 \((\Sigma_1^{-1}+\Sigma_2^{-1})\) 左乘后得到 \(I\)。利用 \(I-\Sigma_1(\Sigma_1+\Sigma_2)^{-1}=\Sigma_2(\Sigma_1+\Sigma_2)^{-1}\),有
而
这里第二行到第三行应整体结合: \(\Sigma_1^{-1}\Sigma_2+I=\Sigma_1^{-1}(\Sigma_1+\Sigma_2)\)。因此式 (4.7) 成立。 矩阵通常不交换,不能把这些因子的顺序随意改写。
4.2 从协方差恢复框体积
在 \(1/4\) 映射下,\(d\) 维框的协方差特征值为
其中 \(s_j\) 是第 \(j\) 条边长。因此
框的 \(d\) 维体积为
二维时 \(V_B=4\sqrt{|\Sigma|}=wh\);三维时 \(V_B=8\sqrt{|\Sigma|}=whl\)。KFIoU 定义
这在形式上复制了 \(I/(A_1+A_2-I)\),但 \(V_\cap\) 不是两个矩形的真实交集面积。尤其式 (4.5) 与 \(\mu_1-\mu_2\) 完全无关:把两个框移得任意远,只要形状不变,式 (4.14) 就不变。因此论文另设中心 损失先拉近中心,再让 KFIoU 负责形状与方向 6。
4.3 KFIoU 上界的完整证明
KFIoU 甚至在两个框完全相同时也不是 1。下面把这个容易被后处理掩盖的事实严格证明出来。
先看最直观的相同协方差情形:\(\Sigma_1=\Sigma_2=\Sigma\) 时,精度相加给出 \(\Sigma_\cap=\Sigma/2\)。二维面积与 \(\sqrt{\det\Sigma}\) 成正比,因此代理交集面积只有原面积 的一半,得到 \((V/2)/(2V-V/2)=1/3\)。这解释了为什么完美形状匹配也不是 1。
下面再证明不同协方差不会超过这个值。AM--GM 是“算术平均不小于几何平均”,对正数 \(x,y\) 写作 \(x+y\ge2\sqrt{xy}\)。证明先把矩阵化成正特征值上的乘积,再逐个使用这一标量不等式。
对正定矩阵 \(A,B\),令 \(C=A^{-1/2}BA^{-1/2}\),其正特征值为 \(r_1,\ldots,r_d\)。则
由一维 AM--GM,\(1+r_j^{-1}\ge 2r_j^{-1/2}\),逐项相乘得到
取倒数再开平方:
代入式 (4.12),若 \(q=\sqrt{V_1V_2}\),则
另一方面,标量 AM--GM 给出 \(V_1+V_2\ge2q\)。函数 \(z/(a-z)\) 在 \(0<z<a\) 上随 \(z\) 单调增加,所以
等号要求式 (4.16) 与两个 AM--GM 同时取等,恰为 \(A=B\)。二维最大值是 \(1/3\),三维最大值是 \(1/(2^{5/2}-1)\),都不是 1。KFIoU 论文使用单调后处理,例如
来形成训练项 6;单调变换不会把式 (4.14) 变成真正的 IoU。
五、MKIoU:调制 KFIoU,并给正方形补回角度
MKIoU 直接针对两个缺口:KFIoU 在高重叠区的曲线与 SkewIoU 不够一致,以及整框 Gaussian 对 正方形角度完全失明 7。
5.1 从 KFIoU 的标量展开到调制式
先说明本节的任务:前一章的 KFIoU 最大只有 \(1/3\),能否重新映射到最大值 1,并调节接近最佳 形状时的惩罚斜率?MKIoU 的调制式就是为此设计的 7。它仍不含中心差,因此本节先比较形状, 中心误差留给后面的独立项。
原论文写出的 \(A,B\) 不是另两个自由参数,而是两个框面积与代理交集面积的比值。记 \(V_p=V_B(\Sigma_p),V_g=V_B(\Sigma_g)\),由第 4 章的乘积协方差,
于是定义
还可以把它们化成宽高和角度。二维矩阵满足 \(\det(I+X)=1+\operatorname{Tr}X+\det X\);令 \(T_{pg}=\operatorname{Tr}(\Sigma_g^{-1}\Sigma_p)\),\(T_{gp}\) 则交换两下标,得到
其中 \(T_{pg}\) 已在式 (2.15) 完整展开为宽高比、\(\cos^2\Delta\theta\) 和 \(\sin^2\Delta\theta\),\(T_{gp}\) 用同式交换预测和真值即可。这就说明原论文的大段根号式从哪里 来,也避免把 \(A,B\) 当作未定义的符号。
将 KFIoU 的分子分母同时除以 \(V_\cap>0\),便得到式 (5.2)。再由二维上界 \(\operatorname{KFIoU}\le1/3\),等价得到
并将原 KFIoU 写成
调制参数 \(\alpha<4\) 后定义
式 (5.1) 立即给出分母至少为 \(4-\alpha>0\),因此
当且仅当两个协方差相同时 \(A+B=4\),式 (5.3) 等于 1。这里不要求中心相同, 也不能区分整框 Gaussian 已经丢掉的正方形角度。因此“相似度等于 1”不能直接解释为原框完全 重合。若 \(\alpha=1\),则
所以 MKIoU 不是从新的概率距离定理推出的量,而是用 \(\alpha\) 改变高重叠区域斜率的检测设计。
具体地,令 \(t=A+B\ge4\),将形状损失记为 \(1-\operatorname{MKIoU}\),则
这就是“调制斜率”的具体含义:\(\alpha\) 越接近 4,最佳形状附近对 \(t\) 的变化越敏感。但这里是 对汇总量 \(t\) 求导,并不保证每一个原始框参数在所有位置都有非零梯度。
5.2 Gaussian Angle Loss 的周期和梯度
重新标定相似度只能改变数值曲线,不能创造已经丢掉的信息。正方形的协方差与角度无关,所以 MKIoU 还需要额外读入预测角和标注角。这个补偿最好主要用于接近正方形的目标,细长目标已有较强 的形状方向信号;下面的指数系数就是这样一个随长宽比变化的“开关”。
设 \(\Delta\theta=\theta_p-\theta_g\),目标长宽为 \(w_g,h_g\)。论文定义 7
这里 \(\beta\ge0\) 控制角度项的总体权重,\(\lambda>0\) 控制离开正方形后权重衰减得多快。 下面关于指数衰减的解释需要 \(\lambda>0\);若取 \(\lambda=0\),系数恒为 \(\beta\),便不再有 长宽比门控。
先解释长宽比门控。令 \(r=w_g/h_g>0\),则由 AM--GM,
当且仅当 \(r=1\) 时指数为 0,门控系数达到 \(\beta\);\(r\) 远离 1 时指数迅速变负,角度补偿趋近 0。再看周期:
它正好具有正方形的 \(90^\circ\) 周期。对预测角求导时,指数系数与 \(\theta_p\) 无关,而且
令 \(z=2\Delta\theta\),\(\mathrm dz/\mathrm d\theta_p=2\),故
MKIoU 论文的导数展示式漏写了 \(\beta\);只有取 \(\beta=1\) 时原展示式才成立。令 \(c_{ip},c_{ig}\) 分别表示预测框和真值框在 \(i\in\{x,y\}\) 方向的中心坐标,最终回归设计为
这也说明 GA Loss 是显式增加的信息通道:它不能从已经各向同性的 \(\Sigma\) 中“恢复”角度,而是 重新使用原始标注角 \(\theta_g\)。
还需保留两个边界。其一,在 \(\Delta\theta=\pi/4\) 时,这个角度项达到最大值,但式 (5.10) 的 导数仍为 0;“能区分角度”不等于“任何错误角度都有非零梯度”。其二,门控只依赖真值长宽比, 交换预测和真值后一般会改变权重,所以 GA 项及 MKIoU+GA 一般不对称。单独的 MKIoU 才对称。
式 (5.11) 中 \(L_{\rm smoothL1}\) 是接近零时用二次误差、偏差较大时用线性误差的函数。例如阈值 为 1 时,令 \(e=c_{ip}-c_{ig}\),它等于 \(e^2/2\)(\(|e|<1\))或 \(|e|-1/2\)(\(|e|\ge1\))。 这个中心项若直接用像素坐标,并不对共同缩放保持不变。因此 MKIoU 和 GA 的尺度性质不能不加 条件地扩展到包含中心项的整个回归损失。
六、G-Rep:任意点集如何通过 MLE 压缩成 Gaussian
G-Rep 把输入从固定五参数 OBB 推广为点集,因此可以统一表示 OBB、四边形框和点预测 8。核心 是对点集拟合 Gaussian,再使用 WD、KLD 或 Bhattacharyya 距离;这一步需要明确压缩掉了什么。
6.1 均值和协方差的最大似然推导
“最大似然”可以先理解为一个拟合问题:点的位置已经给定,我们改变 Gaussian 的中心和宽度, 使这些点在该模型下获得尽可能大的联合密度。这里变化的是模型参数,不是这些点。概率密度并非 单点概率,所以密度大于 1 并不矛盾。
把预测点当成独立 Gaussian 样本,是为了定义拟合准则;并不声称检测器预测的顶点真由独立随机 采样产生。得到的 Gaussian 只是对点集的摘要,能留下中心、展开程度和主方向,却可能丢掉边界 细节。
给定 \(N\) 个 \(d\) 维点 \(x_1,\ldots,x_N\),假设它们独立来自 \(\mathcal N(\mu,\Sigma)\)。联合似然为
取对数:
先固定 \(\Sigma\) 对 \(\mu\) 求导。因为对称矩阵 \(A\) 满足
所以
令其为 0,并左乘可逆的 \(\Sigma\):
再用精度矩阵 \(\Lambda=\Sigma^{-1}\) 求协方差,这会比直接对逆矩阵求导清楚。令 \(r_i=x_i-\hat\mu\),利用 \(\log|\Sigma|=-\log|\Lambda|\) 以及 \(r_i^\top\Lambda r_i=\operatorname{Tr}(\Lambda r_ir_i^\top)\),有
为什么换成精度矩阵更方便?在式 (6.6) 中,数据相关的第二项对 \(\Lambda\) 已经是线性的,唯一的 非线性项只剩 \(\log|\Lambda|\)。令 \(S=\sum_i r_ir_i^\top\),其中 \(S\) 在优化 \(\Lambda\) 时固定。 对可逆矩阵,行列式微分满足 \(\mathrm d|\Lambda|=|\Lambda|\operatorname{Tr}(\Lambda^{-1}\mathrm d\Lambda)\);再用一元链式 法则除以 \(|\Lambda|\),便得到下面的第一条公式。
矩阵微分恒等式为
因此一阶条件是
由于 \(\Lambda^{-1}=\Sigma\),得到
分母是 \(N\),不是无偏样本协方差的 \(N-1\):这里优化的是这一组数据的 Gaussian 似然,而非要求 估计量在重复抽样中无偏。在样本协方差正定的条件下,这个驻点确实是最大值。原因是 \(\log\det\Lambda\) 在正定矩阵上严格凹,而式 (6.6) 的另一项为线性项;沿任何非零对称扰动 \(H\),二阶变化包含 \(-\operatorname{Tr}(\Lambda^{-1}H\Lambda^{-1}H)<0\),因此不会把极小点误当极大点。
满秩条件不能省略。 中心化后的 \(N\) 个向量之和为 0,所以 \(\operatorname{rank}(\hat\Sigma)\le\min(d,N-1)\)。当 \(N\le d\) 时一定奇异;即使 \(N>d\), 若所有点仍在一条直线或更低维的仿射子空间里,也可能奇异。只有点集在仿射意义上张成整个 \(d\) 维空间,式 (6.9) 才是一个非退化 Gaussian 的合法最大似然协方差。
退化时式 (6.9) 仍给出正确的经验二阶矩,但在“协方差必须正定”的 Gaussian 模型中, 不存在这样的有限最优解:把没有样本散布的方向的方差不断压到 0,似然会不断增大。实现中的 \(\hat\Sigma+\varepsilon I\) 是有意加入的数值正则化,不是原始无约束最大似然解; \(\varepsilon\) 的量纲应与协方差一致。
采样位置也会决定编码。把矩形的四个顶点作为等权样本,局部横坐标都是 \(\pm w/2\),得到方差 \(w^2/4\);若改为矩形内部的均匀分布,则由第 1.2 节得到 \(w^2/12\)。“同一个矩形拟合 Gaussian” 并不唯一,必须先说清楚拟合的是哪些点、各点的权重是什么。
6.2 二阶矩压缩不是可逆表示
考虑两个四点集合
两者因中心对称都有 \(\hat\mu=0\)。对 \(\mathcal A\),
对 \(\mathcal B\),每一点的两个平方坐标都是 \(a^2=1/2\),而四个交叉项 \(a^2,-a^2,-a^2,a^2\) 相消,故
一个点集位于坐标轴上,另一个位于正方形四角,几何结构明显不同,却得到相同的 \((\hat\mu,\hat\Sigma)\)。因此任何 Gaussian 距离都给出 0。G-Rep 的统一性来自二阶矩压缩;其代价是 高阶形状、点顺序和多模态结构不可恢复。对只需一个整体 OBB 的任务这可能合适,对精确多边形边界则 应考虑 P2P 等直接几何方法。
七、从 NWD 到 RKA,以及二维公式怎样扩到三维
7.1 RKA 改的是标签分配,不是距离
到这里我们一直默认“预测框已经知道自己要逼近哪个真值”。训练中却要先决定这种对应关系。 特别是微小目标,固定 IoU 阈值可能把几乎所有候选都判为负样本。RKA 的做法不是重写距离,而是 对每个真值在候选里挑相对最好的若干个,让回归有可用的正样本。
原始 NWD 给任意水平框与 anchor 一个相似度
NWD 的期刊扩展把它用于 Ranking-based Assignment(RKA)9。对第 \(g\) 个真值和 \(M\) 个候选 anchor,先计算
再取使分数从大到小排列的置换 \(\pi_g\):
正样本集合定义为
这里 \(1\le k\le M\),并应为同分候选规定稳定的并列处理规则。与固定阈值 \(S_{gj}\ge t\) 相比, 式 (7.4) 为每个真值先选出相同数量 \(k\) 的正样本候选,避免微小目标因为 像素离散和极低 IoU 几乎没有正样本。由于指数函数严格单调递减,
所以在同一个 \(C>0\) 下,按 NWD 降序与按原始 \(W_2\) 升序完全等价;\(C\) 不改变 top-\(k\) 排名。 但 \(C\) 会改变把相似度直接放进 loss 或阈值判断时的数值。论文实验默认 \(k=2\),这是超参数而非 Wasserstein 理论结论 9。
候选同时进入多个 \(\mathcal P_g\) 时仍需检测框架的冲突消解规则;若每个候选最终只能归一个 真值,消解后的每个真值不一定还保留恰好 \(k\) 个正样本。RKA 说明同一个距离可以出现在 三个位置:回归 loss、标签分配和 NMS;三者的算法角色不能混写。
7.2 二维/三维 Gaussian 框的统一式
这一小节切换的是空间维数,不是继续改标签分配。二维框有两个主轴,三维框有三个;只要把 每条主轴的边长变成相应方差,再用合法旋转矩阵转到全局坐标,就能重复同一套 Gaussian 计算。
二维旋转框使用 \(R\in SO(2)\)。三维旋转框
这里 \(SO(3)=\{R:R^\top R=I,\det R=1\}\)。正交相似变换保留特征值:
其中 \(D\) 是式 (7.7) 的对角矩阵,所以 \(\Sigma\) 的特征向量给方向,特征值平方根的两倍给边长。
这里“特征向量给方向”需要说明唯一性:特征值互不相同时,主轴方向可确定到符号和排列的 等价关系;重复特征值对应的子空间内可任意旋转,所以不能从协方差中唯一解出那些方向。 体积恢复式正是
Gaussian \(W_2\) 的一般闭式不随维数改变:
KLD 也只需把二维中的常数 \(2\) 换成维数 \(d=3\):
真正困难的不是把 \(2\) 改成 \(3\),而是三维旋转表示:Euler 角有奇异性与多重参数化,四元数有 \(q\) 与 \(-q\) 的二对一关系。若检测头先输出一个合法 \(R\) 或正定 \(\Sigma\),式 (7.7)--(7.11) 才能 直接使用。KFIoU 和后续 2D/3D Gaussian 工作验证了这条扩展路线 610,但它仍继承各向同性物体 方向不可辨的基本限制。
八、换距离还不够:直接修改 Gaussian 表示与检测头
8.1 LGBB:把正定矩阵换成线性坐标
前面的方法大多先让检测头输出宽、高、角度,再把它们转成矩阵。本章反过来问:既然最后要比较 矩阵,能否直接预测矩阵的三个独立元素?困难在于,任意三个实数不一定构成合法协方差。 LGBB 尝试让表示更适合回归;GauCho 则从参数化本身保证正定。这是“怎么输出”的问题,不是 再换一个“怎么比较”的公式。
写二维对称 Gaussian 矩阵为
直接回归 \((g_1,g_2,g_3)\) 的困难是三个实数并不自动保证 \(G\succ0\)。LGBB 使用线性变换 11
也就是
反变换逐步解得
所以
二维对称矩阵正定当且仅当首个顺序主子式与行列式为正:
论文的训练项把违反行列式约束的部分罚回去:
校正:软惩罚不等于正定保证。 式 (8.2) 只是可逆线性换坐标;式 (8.9) 的额外项只在行列式 为负时产生正惩罚,鼓励网络向合法区域移动,但并没有施加严格的可行域约束。行列式等于 0 时, 矩阵已经不可逆,该项却仍为 0;\(G=-I\) 的行列式为 1,该项也为 0,但它是负定矩阵。
因此,网络的其他激活或参数化还需保证 \(l_2>0\),并妥善处理行列式接近 0 的情形。论文的损失项 应按其训练设计理解,不能只由这一项就推出“每次输出必然正定”。二维判据要求两个严格不等式 同时成立,这与“线性变换可以求逆”是两回事。
8.2 Structure Tensor:如何从三个矩阵元素解码角度
方向不一定非要由一个角度数值表示。也可以用一个椭圆状矩阵间接表示:它的长轴指向目标方向, 矩阵元素随方向连续变化。解码时再从矩阵求回主方向。接下来要回答两个问题:为什么公式里出现 \(2\theta\),以及为什么必须先约定哪一个特征值较大。
结构张量方法写 12
展开旋转乘法:
两条对角线相减:
若约定 \(\lambda_1>\lambda_2\),将式 (8.13)--(8.14) 看成半径为 \(\lambda_1-\lambda_2\)、极角为 \(2\theta\) 的二维向量,便得到
\(\operatorname{atan2}(y,x)\) 同时利用两个坐标的符号来确定象限;只算 \(\arctan(y/x)\) 会丢失 象限信息,而且在 \(x=0\) 时不能直接除。先解出 \(2\theta\) 再除以 2,意味着最后方向只确定到 \(\pi\) 周期,即一条无向轴,而不是带箭头的方向。
校正:仅写 \(\lambda_1\\ne\lambda_2\) 不够。 若实际 \(\lambda_1<\lambda_2\),式 (8.15) 返回的是 \(\theta+\pi/2\pmod\pi\),也就是第二条、更长的主轴,而非原定义的第一条轴。解码时 应先排列特征值并同时排列边长。原论文采用长边约定,正是为了统一这个选择 12。
再求边长信息时,不必把特征值公式当成另一个黑箱。展开 \(\det(\lambda I-T)=0\),得到 \(\lambda^2-(T_{11}+T_{22})\lambda+T_{11}T_{22}-T_{12}^2=0\),应用一元二次方程求根公式即可。
特征值由二次方程得到:
当 \(\lambda_1=\lambda_2\) 时,式 (8.15) 的两个输入都为 0,角度不可定义,这再次证明第 1.4 节的 不可能性。常规形状张量取 \(\lambda_1=w/2,\lambda_2=h/2\);论文为 square-like 目标人为采用
把正方形也变成 \(2:1\) 的各向异性张量,并在 \(|w-h|\le\varepsilon\) 时按 \(\pi/2\) 周期归一角度 12。 式 (8.17) 保住了方向,但 \(T\) 不再是原矩形的真实二阶矩或原框等密度椭圆;这是表示设计, 不是统计估计。
8.3 GauCho:Cholesky 参数为什么始终给出正定矩阵
与其预测一个可能非法的对称矩阵后再惩罚,不如预测一个容易保持可逆的三角矩阵,再将它与自身 转置相乘。这样矩阵的正定性不是训练“学会”的,而是构造本身带来的。下面是二维情形 13。
GauCho 不让检测头先输出 \((w,h,\theta)\),而是直接输出 13
令
对任意非零 \(z\),
因为 \(\alpha\beta\ne0\) 使 \(L\) 可逆,故 \(L^\top z\ne0\)。所以 \(C\succ0\)。反过来,每个正定矩阵都 有唯一一个正对角线的 Cholesky 因子,因而式 (8.18) 与合法协方差之间是双射。
二维时还能直接写出反变换:
正定性保证两个根号内都为正,并由正号约定排除了多解。工程上可对两个未约束输出使用指数函数, 或 \(\operatorname{softplus}(z)=\log(1+e^z)\) 后再加正的小量,使对角线保持正数;这是合法参数化的 示例,具体模型的激活与尺度仍应以其实现为准。正定不等于数值状况一定良好:一条对角线过小 仍可能导致矩阵近乎奇异。
下文给参数界,是为了看懂三角因子的尺度如何由原矩阵的尺度控制。所谓 Rayleigh 商,就是 \(z^\top Cz/(z^\top z)\);把 \(z\) 展开到特征向量基底后,它是特征值的加权平均,因此落在最小和 最大特征值之间。取 \(z=e_1=(1,0)^\top\),就能得到对 \(\alpha\) 的界。
下面补全 GauCho 参数界。设 \(C\) 的特征值为 \(0<\lambda_{\min}\le\lambda_{\max}\)。Rayleigh 商给出
于是
又因为
有
把式 (8.21) 的上下界代入分母,得到
最后证明非对角参数的紧上界。写 \(a=\sqrt{\lambda_{\max}},b=\sqrt{\lambda_{\min}}\),并把 \(C\) 特征分解为旋转角 \(\theta\),则
我们要证明 \(|\gamma|\le a-b\)。先单独处理 \(a=b\):此时式 (8.27) 给出 \(\gamma=0\), 结论成立。以下设 \(a>b\)。将不等式平方,代入式 (8.26)--(8.27),再除以正数 \((a-b)^2\),便等价于
右边减左边恰好是
故
GauCho 解决的是检测头输出合法协方差和角度边界连续性;它可以搭配 GWD、KLD、ProbIoU 等多种 loss,本身不是一种新的 WD 13。
这里的双射是“三角因子与正定矩阵”之间的双射,不是“所有旋转框与正定矩阵”之间的双射。 正方形不同角度仍可能对应同一个矩阵,换成 Cholesky 参数并不能单独消除第 1.4 节的信息丢失。
8.4 人工各向异性表示能做什么,不能声称什么
Structure Tensor 与 2025 年 anisotropic GBB 都采用“故意打破各向同性”的思路 1216。后者 对 square-like 框使用依赖 \(4\theta\) 的旋转与长宽扰动,使表示具有 \(\pi/2\) 周期而不对其他角度 恒等 16。抽象写成
两个特征值不同,意味着这个编码矩阵自身有可辨的主轴;按大小排列后可用式 (8.15) 解码。但要进一步辨认原始角 \(\theta\),还必须保证整个映射随 \(\theta\) 变化,并在目标允许的 周期等价之外不把不同角度映为同一个矩阵。例如,固定两个不相等的特征值却完全不让矩阵随 \(\theta\) 变化,就仍然没有角度信息。因此“人为制造各向异性”提供了编码方向的可能性, 并不单独证明映射可逆,也不保证最终损失在所有错误角度处都有非零梯度。
但它有两点边界。第一,\(\Sigma'\) 不再是原矩形均匀分布的协方差,因而 Bhattacharyya 或 WD 比较的是“设计后的编码”,不是原区域的概率二阶矩。第二,该论文用大量随机三元组未发现反例来 支持某个后处理 loss 的三角不等式 16;有限随机检验不是对无限连续空间的数学证明。本文只把其 当作实验观察,不升级为定理。
九、GCD:严格尺度不变,但不是数学度量
先用两个数字理解本章的动机:同样偏移 2 像素,对宽 4 像素的框是半个框宽,对宽 40 像素的框 只是二十分之一个框宽。NWD 的固定常数统一衡量像素距离;GCD 则想用框自身的宽高衡量相对偏差。 分别用预测框和真值框的尺度归一,再求平均,就能避免只偏向其中一方。
GCD 是对 NWD 固定像素常数 \(C\) 的后续批评:它使用预测框和目标框各自的尺度归一中心误差与形状 误差,再对两个方向求平均 14。对水平框,论文给出的可直接计算标量式为
其中 \(\Delta x=x_p-x_g,\Delta y=y_p-y_g\)。
可把式 (9.1) 读成“两次打分”:先用预测框的宽高作尺子,计算中心误差和半边长误差;再用真值框 的宽高作尺子,重复计算;最后平均。分母中的宽高必须严格为正。本文先讨论这个明确的水平框标量 定义,再单独检验哪些数学性质成立,避免因为名字里有 distance 就默认它是度量。
9.1 可以严格证明的三个性质
第一,每项都是正数分母上的平方,因此
若 \(D_{gc}^2=0\),所有平方项均为 0,于是 \(x_p=x_g,y_p=y_g,w_p=w_g,h_p=h_g\);反向显然也成立。故它满足非负性与同一性。
第二,交换 \(p,g\) 只会交换式 (9.1) 第一、三项以及第二、四项,所以
第三,对共同的正尺度变换
每个分子与分母都乘 \(s^2\)。例如
故
这是严格的共同尺度不变性;NWD 的 \(\exp[-W_2(B_p,B_g)/C]\) 在 \(C\) 固定时没有这个性质。
9.2 三角不等式反例
“非负、对称、尺度不变”仍不足以成为数学度量。固定中心与高度,只让宽度取正数 \(a,b\)。式 (9.1) 退化为
因而若把 \(d(a,b)=\sqrt{D_{gc}^2(a,b)}\) 当距离,
取 \(a=1,b=2,c=4\):
而
比较平方前的正数即可:
所以
违反三角不等式。GCD 可以是有用的检测 dissimilarity,但“metric”若按严格数学定义理解并不 成立。
9.3 一般仿射不变性论证的矩阵问题
共同可逆仿射变换下,Gaussian 协方差变成 \(\Sigma'=M\Sigma M^\top\)。KLD 和 Bhattacharyya 的不变性可通过逆矩阵与行列式严格证明;但不能 使用
最简单的反例取 \(\Sigma=I\)、\(M=\operatorname{diag}(2,1)\):
而
二者不等。只有额外条件下才能把主平方根这样移出合同变换。因此 GCD 论文一般矩阵式中的仿射证明 不能直接由式 (9.13) 得到 14。这不否定已经由标量式严格证明的共同平移与尺度不变性,但必须 收窄结论范围。
十、P2P:不经 Gaussian,直接度量凸多边形
Polygon-to-Polygon Loss 代表另一条路线:旋转框先转成四个顶点,直接比较两个凸多边形 15。 令
顶点按同一方向排列,\(E_B^j=(v_B^j,v_B^{j+1})\),下标循环。
10.1 点到边的三角形面积
这里不再压缩成均值和协方差,而是保留每个顶点。点与一条边组成一个三角形,其面积就是“边长 乘点到边所在直线的距离再除以 2”。对多边形的所有边求和后,点在内部时这些三角形恰好铺满 多边形;点在外部时,无向面积和会多出一块。这就是下面外部偏离量的几何来源。
本节要求两个多边形都是面积为正的凸多边形,顶点沿边界按同一旋转方向排列。若预测顶点 自交、无序,或者直接套在非凸多边形上,后面的内外判定证明就不再适用。
二维向量叉积定义为
点 \(p\) 与边 \((q_j,q_{j+1})\) 构成的无向三角形面积为
把它对 \(B\) 的所有边求和:
为什么这个量能判断点是否在凸多边形内?先去掉绝对值,利用叉积双线性:
因为两个含 \(p\) 的循环和相消。右边的一半绝对值正是鞋带公式给出的 \(S_B\)。若 \(p\) 在凸多边形 内部,所有有向三角形符号一致,绝对值不改变总和,所以
若 \(p\) 在外部,至少有一条边对应的有向面积符号相反。由严格三角不等式 \(\sum|a_j|>|\sum a_j|\),得到
因此 \(S_{VP}-S_B\) 是非负的凸多边形外部偏离量。
10.2 从顶点到对称多边形 loss
对 \(A\) 的每个顶点累加:
单向平均偏离为
为了避免只检查 \(A\) 的顶点是否在 \(B\) 内,再加反方向:
式 (10.10) 显然非负且交换 \(A,B\) 不变。对相同凸多边形,每个顶点都在另一个多边形边界上, 所以 \(d=0\)。论文再用总面积消除共同尺度:
共同放大 \(s\) 倍时,所有三角形和多边形面积都乘 \(s^2\),所以式 (10.11) 不变。最终损失为
其中另两个项控制中心与形状 15。式 (10.11) 的尺度不变性针对归一化多边形项,整个 式 (10.12) 是否尺度不变还取决于 \(L_c,L_{sp}\) 的定义与坐标归一,不能仅从其中一项推出。
校正:要区分分段线性函数与它的梯度。 固定边的两个端点,只让 \(p\) 变化时,叉积展开后 是关于 \(p\) 的仿射函数,取绝对值后是分段仿射函数;其对 \(p\) 的梯度在每个符号区域内为常数。 若两个多边形的顶点同时变化,则出现双线性项;再除以可变面积,最终损失一般只是分段光滑, 并不是统一的“分段线性梯度”。绝对值在符号切换处需要次梯度或实现中选定的求导约定。
在本节的凸性条件下,式 (10.10) 为 0 还意味着 \(A\) 的所有顶点在 \(B\) 中,且反向也成立, 所以两个凸区域相同。这不要求顶点起始编号相同。P2P 保留顶点几何,能比较正方形旋转后真实 边界的变化;但它不会把相差 \(\pi/2\) 的同一个正方形区域视为不同的有向物体。
十一、总结:把全部方法放回同一坐标系
11.1 数学对象与性质总表
| 方法 | 比较对象 | 对称 | 共同尺度不变 | 正方形角度可辨 | 是否严格度量 |
|---|---|---|---|---|---|
| 原始 Gaussian \(W_2\) 1 | 两个整框 Gaussian | 是 | 否 | 否 | 对分布是;不含后处理 |
| NWD 2 | \(W_2\) 的指数归一 | 是 | 固定 \(C\) 时否 | HBB 不涉及 | 否,属相似度 |
| EWD 3 | 对应边支撑分布 | 是,含循环最小化后 | 论文另归一 | 是,模 \(\pi/2\) | 通常不是 |
| KLD 4 | 两个整框 Gaussian | 否 | 是 | 否 | 否 |
| ProbIoU 5 | \(1-H\) 概率相似度 | 是 | 是 | 否 | 相似度不是度量;\(H\) 才是 |
| KFIoU 6 | Gaussian 乘积体积 | 是 | 是 | 否 | 否 |
| MKIoU 7 | 调制后的协方差体积比 | 是 | 是 | 否 | 否 |
| MKIoU+GA,不含中心项 7 | 调制乘积加目标侧角度门控 | 一般否 | 是 | 是,模 \(\pi/2\) | 否 |
| G-Rep 8 | 点集的经验矩 Gaussian | 取决于所选距离 | 取决于所选距离 | 各向同性时否 | 对点集不是;对分布另看所选距离 |
| GCD 14 | 双向相对中心/形状误差 | 是 | 是 | HBB 不涉及 | 否,式 (9.12) |
| P2P 归一化几何项 15 | 两个凸多边形 | 是 | 是 | 是,模 \(\pi/2\) | 未证明为度量 |
表中的“\(W_2\) 是度量”只针对 Gaussian 概率分布本身。论文再施加 \(1-1/(\tau+f(W_2^2))\) 后,是否保留三角不等式需要另证,不能从原始 \(W_2\) 自动继承。
表中每一行都要按“比较对象”一列的范围阅读:\(W_2^2\) 与 \(W_2\) 不同,基础量与最终总损失也 不同。MKIoU+GA 和 P2P 行未把未归一的中心损失包含在内;若加入这些项,需重新检查整体尺度 性质。对分布的度量经非单射的框或点集编码拉回后,至多先得到允许不同原对象距离为零的 伪度量,不能直接宣称是原始几何对象上的严格度量。
“正方形角度可辨”表示能辨认旋转后区域形状确实不同的情况。相差 \(\pi/2\) 的正方形本来 就是同一个区域;仅凭框几何不能区分它的朝前、朝后等完整语义方向。这些任务需要额外的有向 标注或信息,不能仅更换框距离。
11.2 面向检测任务的选择结论
- 普通水平框,尤其微小目标:NWD 最简洁,水平闭式就是 \((x,y,w/2,h/2)\) 的欧氏距离;若主要问题是正样本太少,应关注 RKA,而不只是替换回归 loss 29。
- 细长旋转框:GWD、KLD、ProbIoU 都能联合耦合长宽与角度。GWD 有像素单位且远处仍有 比较信号;KLD/ProbIoU 具有共同 Gaussian 仿射变换下的不变性,但权重与饱和行为不同。 原始 \(W_2^2\) 的形状项不依赖中心距离,最终 GWD 后处理仍可能压缩远处梯度,不能一概说 “距离远就一定有很强梯度” 145。
- 需要辨认正方形旋转后的边界差异:任何仅依赖整框二阶矩的 loss 都不可能解决。 必须增加边、顶点、 显式角度项或人工各向异性表示,如 EWD、MKIoU+GA、P2P、Structure Tensor 371215。
- 圆形或本来无方向的类别:强行恢复角度可能反而让标注不自洽。GauCho 的 Gaussian/OE 观点提醒我们先问“任务是否真的有可观察方向”,再决定是否惩罚各向同性 13。
- 标签分配:第 7.1 节的 NWD-RKA 用相似度排序选择正样本,改变的是哪些预测参与回归。 因此应把分配策略与回归 loss 分开验证,不能把整体检测收益全部归因于距离公式 9。
最重要的判断顺序不是先挑一个流行的 loss,而是:
若表示层已经把角度压没,后面无论换多少种 Gaussian 距离都无法恢复;若基础距离有量纲,外部归一化就会成为数据集相关超参数;若最终目的其实是分配,单框回归距离的性质也不等于全局匹配的性质。
参考文献
-
Xue Yang, Junchi Yan, Qi Ming, Wentao Wang, Xiaopeng Zhang, and Qi Tian. “Rethinking Rotated Object Detection with Gaussian Wasserstein Distance Loss.” Proceedings of ICML, 2021. arXiv:2101.11952v4. ↩↩↩↩↩↩
-
Jinwang Wang, Chang Xu, Wen Yang, and Lei Yu. “A Normalized Gaussian Wasserstein Distance for Tiny Object Detection.” 2021. arXiv:2110.13389v2. ↩↩↩↩↩↩
-
Yuke Zhu, Yumeng Ruan, Zihua Xiong, and Sheng Guo. “Edge Wasserstein Distance Loss for Oriented Object Detection.” 2023. arXiv:2312.07048v1. ↩↩↩↩↩↩
-
Xue Yang, Xiaojiang Yang, Jirui Yang, Qi Ming, Wentao Wang, Qi Tian, and Junchi Yan. “Learning High-Precision Bounding Box for Rotated Object Detection via Kullback-Leibler Divergence.” NeurIPS, 2021. arXiv:2106.01883. ↩↩↩↩↩↩↩↩
-
Jeffri M. Llerena, Luis Felipe Zeni, Lucas N. Kristen, and Claudio Jung. “Gaussian Bounding Boxes and Probabilistic Intersection-over-Union for Object Detection.” IEEE Transactions on Image Processing, 2024. arXiv:2106.06072. ↩↩↩↩↩↩↩↩
-
Xue Yang, Yue Zhou, Gefan Zhang, Jirui Yang, Wentao Wang, Junchi Yan, Xiaopeng Zhang, and Qi Tian. “The KFIoU Loss for Rotated Object Detection.” ICLR, 2023. arXiv:2201.12558. ↩↩↩↩↩↩↩↩
-
Xinyi Yu, Jiangping Lu, Mi Lin, and Linlin Ou. “MKIoU Loss: Towards Accurate Oriented Object Detection in Aerial Images.” 2022. arXiv:2206.15109. ↩↩↩↩↩↩↩↩
-
Liping Hou, Ke Lu, Xue Yang, Yuqiu Li, and Jian Xue. “G-Rep: Gaussian Representation for Arbitrary-Oriented Object Detection.” Remote Sensing, 2023. arXiv:2205.11796. ↩↩↩↩
-
Chang Xu, Jinwang Wang, Wen Yang, Huai Yu, Lei Yu, and Gui-Song Xia. “Detecting Tiny Objects in Aerial Images: A Normalized Wasserstein Distance and a New Benchmark.” ISPRS Journal of Photogrammetry and Remote Sensing, 2022. arXiv:2206.13996. ↩↩↩↩↩
-
Xue Yang, Gefan Zhang, Xiaojiang Yang, Yue Zhou, Wentao Wang, Jin Tang, Tao He, and Junchi Yan. “Detecting Rotated Objects as Gaussian Distributions and Its 3-D Generalization.” 2022. arXiv:2209.10839. ↩↩
-
Zhen Zhou, Yunkai Ma, Junfeng Fan, Zhaoyang Liu, Fengshui Jing, and Min Tan. “Linear Gaussian Bounding Box Representation and Ring-Shaped Rotated Convolution for Oriented Object Detection.” 2023. arXiv:2311.05410. ↩↩
-
Xavier Bou, Gabriele Facciolo, Rafael Grompone von Gioi, Jean-Michel Morel, and Thibaud Ehret. “Structure Tensor Representation for Robust Oriented Object Detection.” 2024. arXiv:2411.10497. ↩↩↩↩↩↩↩
-
Jeffri Murrugarra-Llerena, Jose Henrique Lima Marques, and Claudio R. Jung. “GauCho: Gaussian Distributions with Cholesky Decomposition for Oriented Object Detection.” CVPR, 2025. arXiv:2502.01565. ↩↩↩↩↩
-
Ziqian Guan, Xieyi Fu, Pengjun Huang, Hengyuan Zhang, Hubin Du, Yongtao Liu, Yinglin Wang, and Qang Ma. “Gaussian Combined Distance: A Generic Metric for Object Detection.” 2025. arXiv:2510.27649. ↩↩↩↩
-
Yang Yang, Jifeng Chen, Xiaopin Zhong, and Yuanlong Deng. “Polygon-to-Polygon Distance Loss for Rotated Object Detection.” Proceedings of AAAI, 36(3), 2022. DOI:10.1609/aaai.v36i3.20214. ↩↩↩↩↩
-
Chien Thai, Mai Xuan Trang, Huong Ninh, Hoang Hiep Ly, and Anh Son Le. “Enhancing Rotated Object Detection via Anisotropic Gaussian Bounding Box and Bhattacharyya Distance.” 2025. arXiv:2510.16445. ↩↩↩↩
-
Solomon Kullback and Richard A. Leibler. “On Information and Sufficiency.” The Annals of Mathematical Statistics, 22(1):79--86, 1951. DOI:10.1214/aoms/1177729694. ↩
-
Anil Kumar Bhattacharyya. “On a Measure of Divergence between Two Statistical Populations Defined by Their Probability Distributions.” Bulletin of the Calcutta Mathematical Society, 35:99--109, 1943. ↩
评论